

Le calcul brut ne suffit plus à lever les goulets d’étranglement de l’inférence IA. XCENA mise donc sur une mémoire mutualisée et capable de traiter les données sur place, afin de réduire les copies et les transferts entre serveurs.
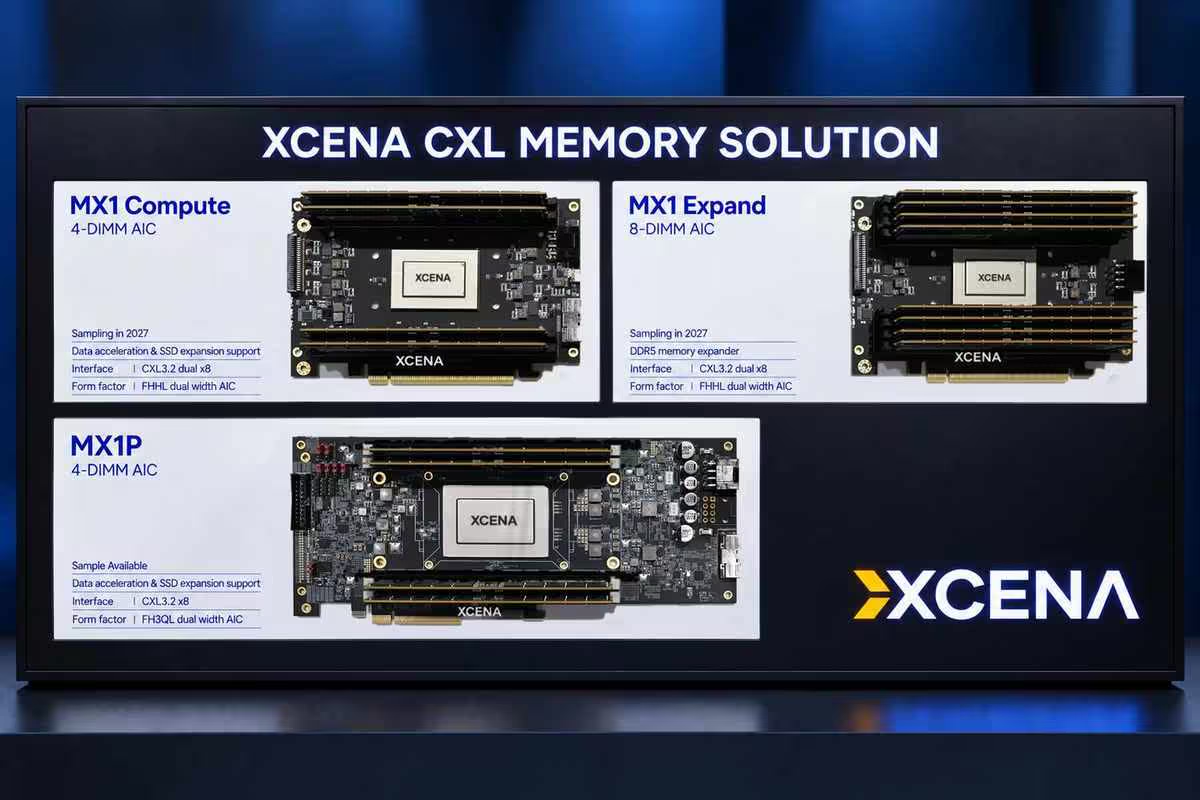
L’entreprise fabless a présenté deux démonstrations reposant sur MX1 lors de l’OCP Global Summit 2026, organisé du 12 au 15 octobre au San Jose McEnery Convention Center. Cette solution de mémoire computationnelle fondée sur Compute Express Link vise à répondre à la hausse des besoins en capacité et au coût croissant des mouvements de données.
La mémoire CXL mutualise le cache KV
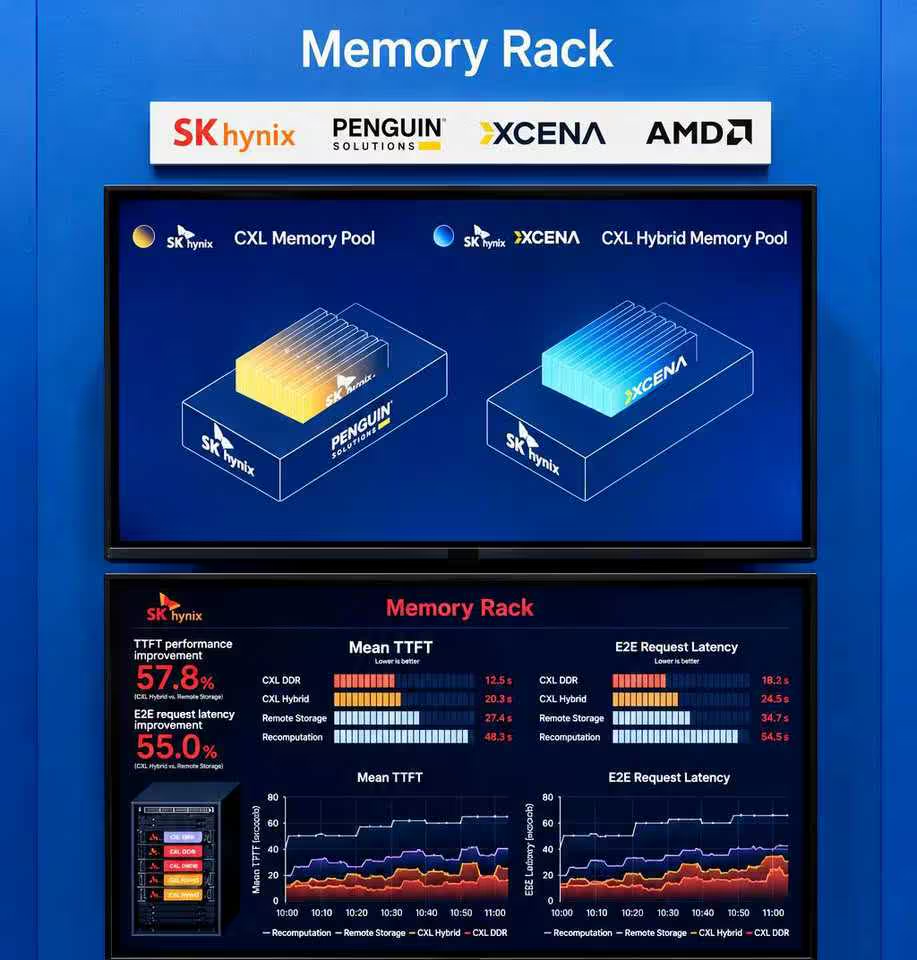
La première démonstration faisait partager un même cache KV à plusieurs serveurs d’inférence IA par l’intermédiaire d’un pool de mémoire CXL. Ce cache conserve le contexte déjà traité par le modèle afin de le réutiliser pendant la génération des réponses.
Sa centralisation évite de dupliquer les mêmes données sur chaque serveur. XCENA entend ainsi réduire les copies redondantes et le trafic entre les nœuds, deux postes particulièrement pénalisants lorsque les séquences s’allongent ou que plusieurs instances servent des requêtes similaires.
La recherche vectorielle exécutée au plus près des données
Le second scénario exploitait la fonction near-data processing de MX1 pour accélérer la recherche vectorielle, une étape centrale des systèmes de génération augmentée par récupération, ou RAG. L’opération est réalisée dans la mémoire où résident les données, plutôt que de transférer régulièrement de volumineux ensembles vers le processeur hôte.
Cette approche s’inscrit dans une logique de traitement proche de la mémoire, où les gains dépendent autant de la baisse des échanges que de la puissance des unités de calcul. Harry Kim, Chief Product Officer de XCENA, a détaillé le 14 octobre l’arrivée de la programmation parallèle généraliste dans ce type d’architecture lors de la session « Bringing General-Purpose Parallel Programming to Near-Data Processing ».
SK hynix valide une architecture hybride adossée au SSD
XCENA travaille parallèlement avec SK hynix sur l’application d’une architecture mémoire CXL hybride aux charges IA. Baptisée InfiniteMemory, la fonction d’extension de MX1 s’appuie sur des SSD pour offrir, d’après les deux partenaires, une capacité nettement plus extensible qu’un CMM-D conventionnel tout en restant plus performante que les SSD seuls.
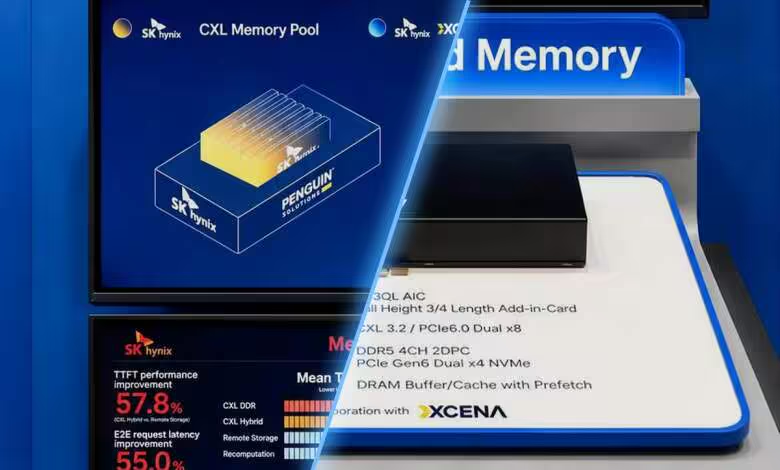
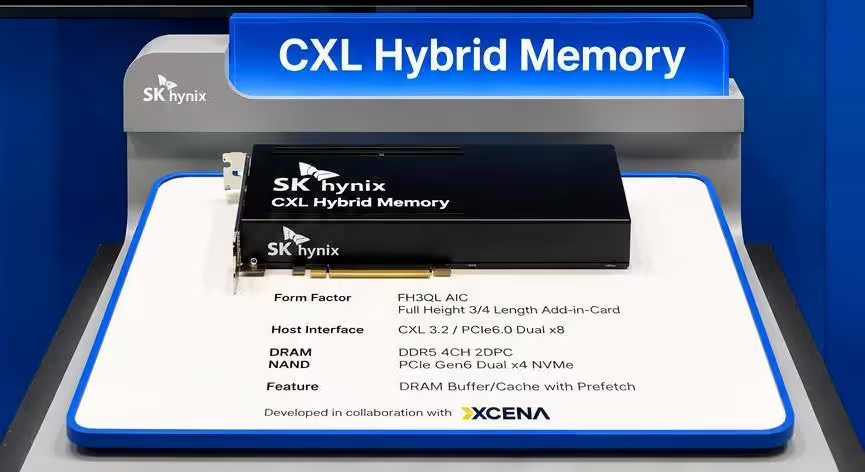
Les entreprises valident désormais cette architecture dans des environnements réels de service IA. Lors du sommet, SK hynix a dévoilé une solution « CXL Hybrid Memory » construite autour de la puce MX1 ainsi qu’une architecture fondée sur RDMA.
Une approche portée dans les travaux de l’OCP
Harry Kim a également participé avec Marvell, Samsung, SK hynix et Gottbrath Technologies au panel « Beyond the Monolith: Open Middleware for Heterogeneous AI Infrastructure at Hyperscale ». Il a coprésenté avec Samsung Electronics la session « Disaggregated CXL Memory Architecture for Agentic AI: Dynamic Pooling, Sharing, and PNM Offloading ».
Grant Mackey, Distinguished Engineer chez XCENA, est intervenu aux côtés de Microsoft, Seagate et Meta pendant la mise à jour technique du sous-projet OCP Composable Memory Systems. Intitulée « Addressing Memory Wall challenge for AI and General Compute platforms », la session portait sur l’avancement du CMS et les prochaines étapes face à l’augmentation des besoins en capacité et en bande passante, pour l’IA comme pour le calcul généraliste.
Pour Jin Kim, CEO de XCENA, l’efficacité des infrastructures IA dépend désormais autant de l’usage de la mémoire et de la suppression des transferts que du calcul. MX1 illustre surtout une évolution plus large : avec le cache KV partagé, le NDP et l’extension par SSD, CXL devient une couche d’architecture susceptible de désagréger la mémoire des serveurs d’inférence, à condition que les gains annoncés se confirment sur des déploiements à grande échelle.
Source : XCENA

