

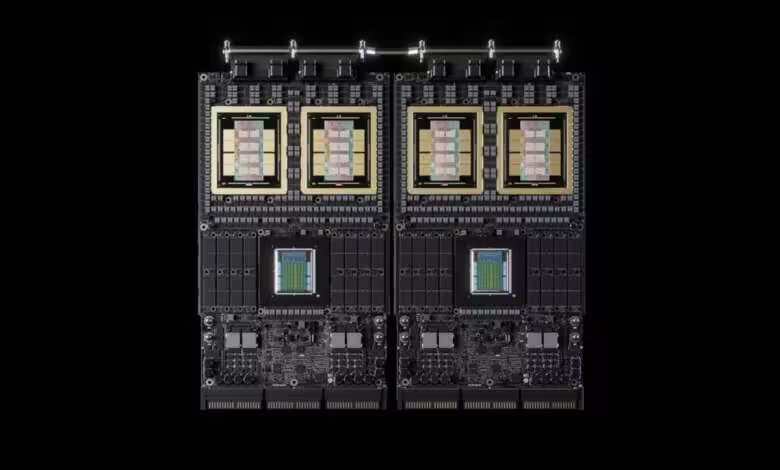
Deux débits structurants de la prochaine plateforme IA de NVIDIA viennent d’être revus à la baisse. Ce compromis électrique laisse aussi davantage d’espace à AMD Helios sur la mémoire et l’interconnexion à l’échelle du rack.
Vera Rubin ralentit sa mémoire HBM4
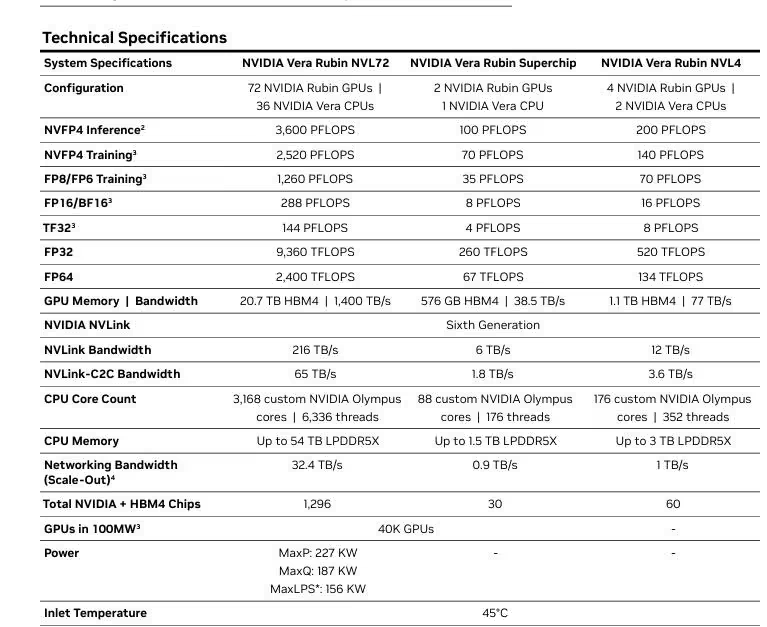
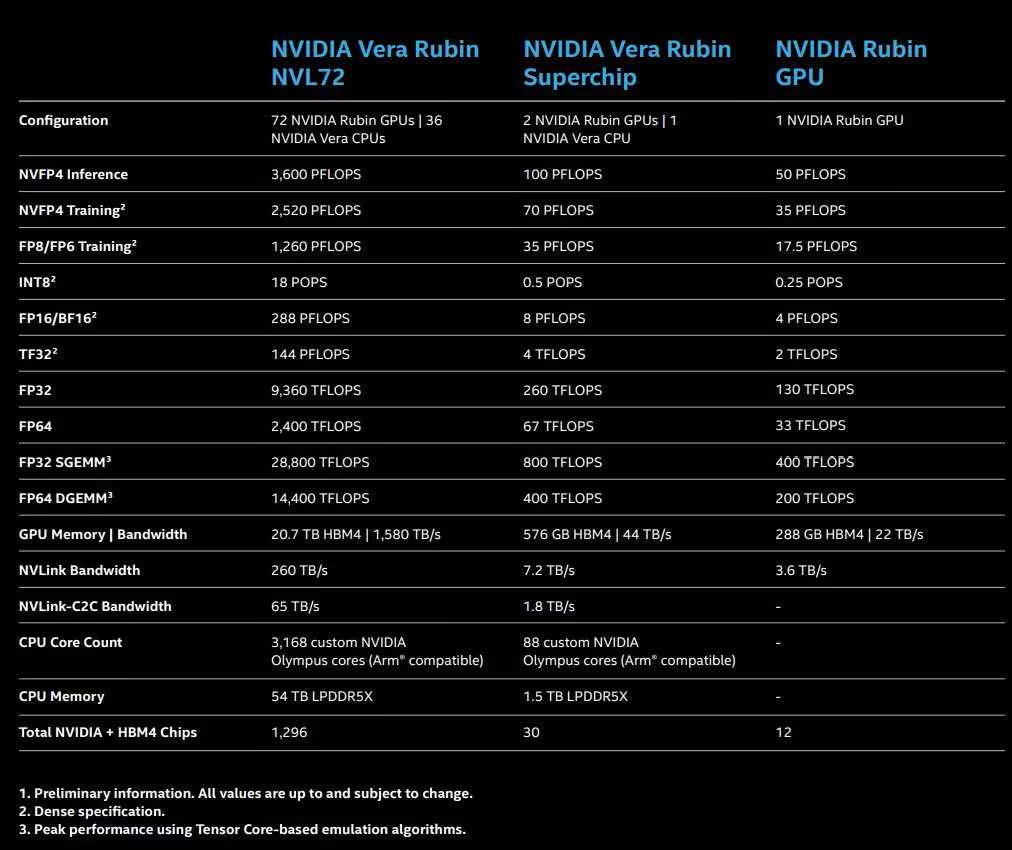
La fiche technique actualisée fixe désormais la HBM4 à 9,6 Gbps par broche, contre 11,7 Gbps auparavant. Dans une configuration Vera Rubin NVL72, la bande passante mémoire cumulée passe ainsi de 1 580 To/s à 1 400 To/s.
Cette révision ne serait pas directement imputable aux fournisseurs de NVIDIA. Elle suggère plutôt que l’implémentation du bus mémoire et la signalisation électrique retenues ne permettent pas de maintenir de manière suffisamment robuste la cible initiale.
NVLink perd 600 Go/s bidirectionnels par GPU
Le NVLink est lui aussi concerné. La bande passante annoncée par GPU recule de 1,8 To/s à 1,5 To/s, soit 3 To/s en bidirectionnel au lieu de 3,6 To/s.
La fréquence de Nyquist visée aurait été abaissée de 56 GHz à 47 GHz pour répondre à des contraintes d’intégrité du signal. Cette réduction allège les exigences imposées aux SerDes, aux câbles et aux matériaux, avec à la clé une meilleure faisabilité industrielle, des rendements potentiellement supérieurs et une stabilité accrue, au prix d’un débit maximal inférieur.
AMD Helios prend l’avantage sur les chiffres du rack
Avec ces nouvelles spécifications, Vera Rubin se place derrière la plateforme rack-scale AMD Helios en capacité comme en bande passante mémoire. Un accélérateur Instinct MI455X embarque 432 Go de HBM4 délivrant 23,3 To/s, contre 288 Go et 19,2 To/s pour Rubin.
À l’échelle de 72 GPU, Helios totalise environ 31 To de HBM4 et 1,67 Po/s de bande passante mémoire. Le Vera Rubin NVL72 atteint approximativement 20,7 To et 1,4 Po/s.
L’écart concerne également le réseau scale-up. L’UALoE d’AMD fournit 3,6 To/s bidirectionnels par GPU, soit 260 To/s agrégés, tandis que le NVLink révisé s’établit à 3 To/s par GPU et 216 To/s sur l’ensemble du rack.
Ces chiffres donnent à Helios un avantage net sur la capacité HBM embarquée et les débits système. Ils ne suffisent toutefois pas à départager seuls deux plateformes dont l’efficacité dépendra aussi des logiciels, des profils de charge et de la capacité à exploiter réellement ces ressources, tandis que le choix de NVIDIA réduit plusieurs risques au moment de l’industrialisation.
Source : Zephyr on X

