

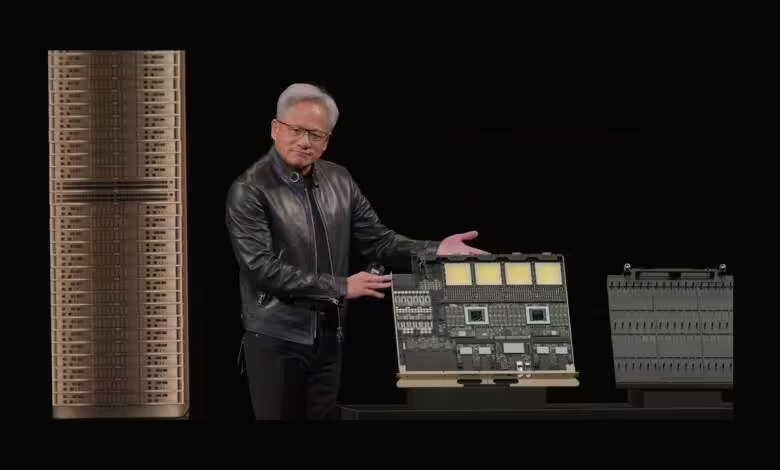
Un rack entier doit bientôt se comporter comme un seul accélérateur, avec 576 GPU reliés par NVLink et une interconnexion optique CPO. NVIDIA dimensionne cette machine pour des modèles d’IA dépassant 10 000 milliards de paramètres, au prix d’une infrastructure hors norme.
Rubin Ultra transforme le rack Kyber en GPU géant
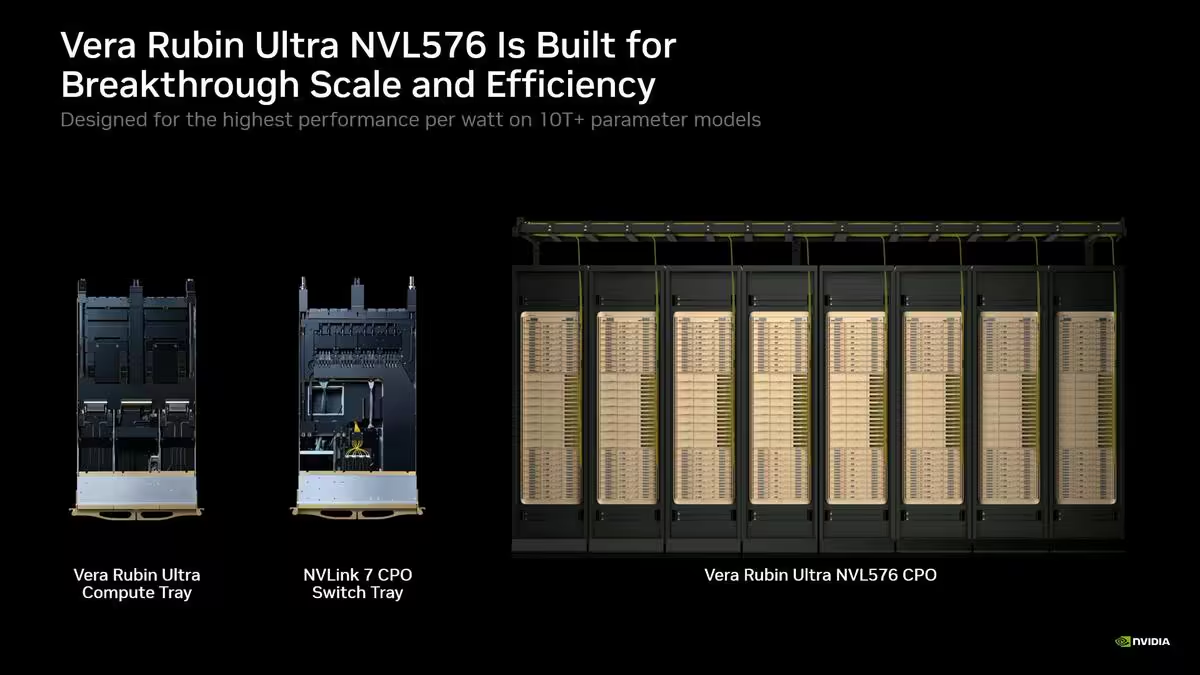
Successeur de Rubin, Rubin Ultra abandonnera le cadre du serveur Oberon NVL72 des plateformes Vera Rubin « VR200 » au profit de Kyber, un rack plus imposant entièrement refroidi par liquide. La déclinaison NVL576 rassemblera 576 GPU, tous connectés par NVLink afin de fonctionner comme une unité cohérente.
Les spécifications présentées par NVIDIA au GTC annoncent 15 Exaflops en FP4 pour l’inférence et 5 Exaflops en FP8 pour l’entraînement. Le constructeur évoque ainsi un gain de performances multiplié par 14 face au système Blackwell GB300 NVL72.
Lors de l’OCP 2026, Ian Buck, vice-président et directeur général des activités Hyperscale et HPC de NVIDIA, a décrit cet ensemble comme le « GPU géant » NVLink offrant les meilleures performances par watt au monde. Son arrivée est annoncée pour l’année suivante, avec pour cible les modèles comptant 10 000 milliards de paramètres.
HBM4E, NVLink 7 et optique CPO au cœur du système
Le GPU Rubin Ultra, annoncé sur une surface équivalente à quatre réticules, pourra intégrer jusqu’à 1 To de HBM4E. À l’échelle du rack, NVIDIA avance 365 To de HBM et une bande passante mémoire cumulée de 4,6 Po/s, soit une capacité multipliée par huit.
L’interconnexion NVLink 7 de nouvelle génération atteindrait 1,5 Po/s, tandis qu’une nouvelle puce ConnectX-9 Spectrum offrirait 115,2 To/s. NVIDIA n’a toutefois pas encore détaillé les conditions exactes derrière ces valeurs agrégées.
Des configurations communiquées à des stades différents
Un tableau comparatif associé au V300 mentionne aussi une configuration Kyber de 144 GPU par rack, contre 72 B300 pour Blackwell Ultra. Cette variante disposerait de 576 Go de HBM4E par GPU, soit 82 944 Go par rack, face à 288 Go de HBM3e par B300 et 20 736 Go sur un rack Blackwell Ultra.
La montée en cadence du B300 y est située entre le second semestre 2025 et le second semestre 2026, celle du V300 entre le second semestre 2027 et le second semestre 2028. Ces chiffres coexistent avec les données plus récentes du NVL576 et semblent donc correspondre à des variantes ou à des étapes distinctes de la feuille de route.
Face aux rumeurs d’une réduction des ambitions de Rubin Ultra, NVIDIA indique « optimiser continuellement le calcul, le réseau et la mémoire » afin d’obtenir le meilleur compromis entre performances et efficacité. Cette formulation ne confirme aucun changement précis de configuration.
Une architecture modulaire conçue autour de l’optique
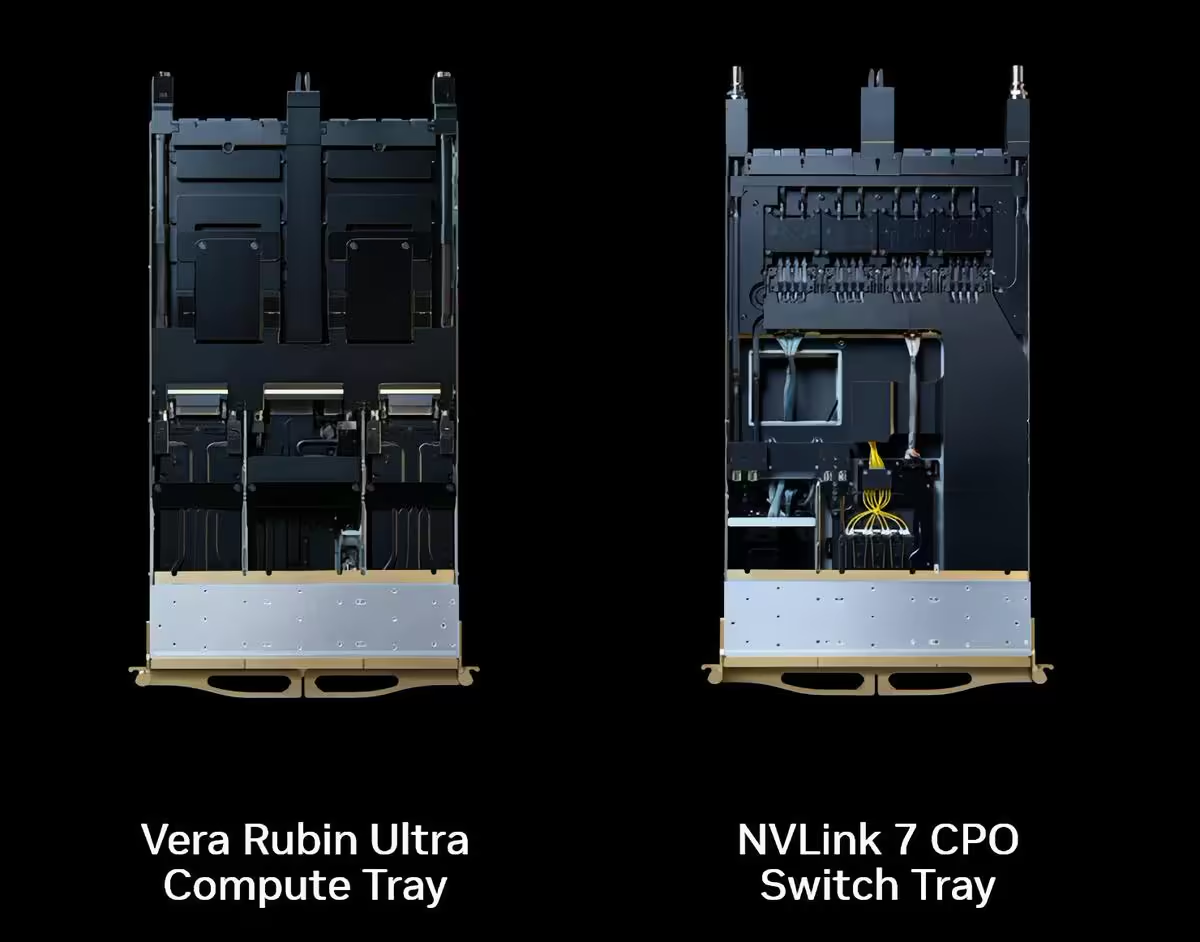
Chaque Vera Rubin Ultra Compute Tray réunira deux GPU Rubin Ultra et un processeur Vera, avec refroidissement liquide. Le NVLink 7 CPO Switch Tray placera les moteurs optiques au plus près de la commutation, les liaisons par fibre devant connecter les GPU et les différents racks.
L’ensemble reposera sur les standards OCP et reprendra la conception modulaire, avec modules enfichables, introduite par Vera Rubin. NVIDIA estime que cette approche ramènera l’installation de plusieurs heures à quelques minutes.
Jensen Huang a par ailleurs déclaré au GTC Berlin que les racks CPO étaient entrés en production de volume, en réponse aux informations évoquant des retards. Rubin Ultra doit devenir le premier système NVIDIA à l’échelle du rack exploitant pleinement cette génération d’optique intégrée.
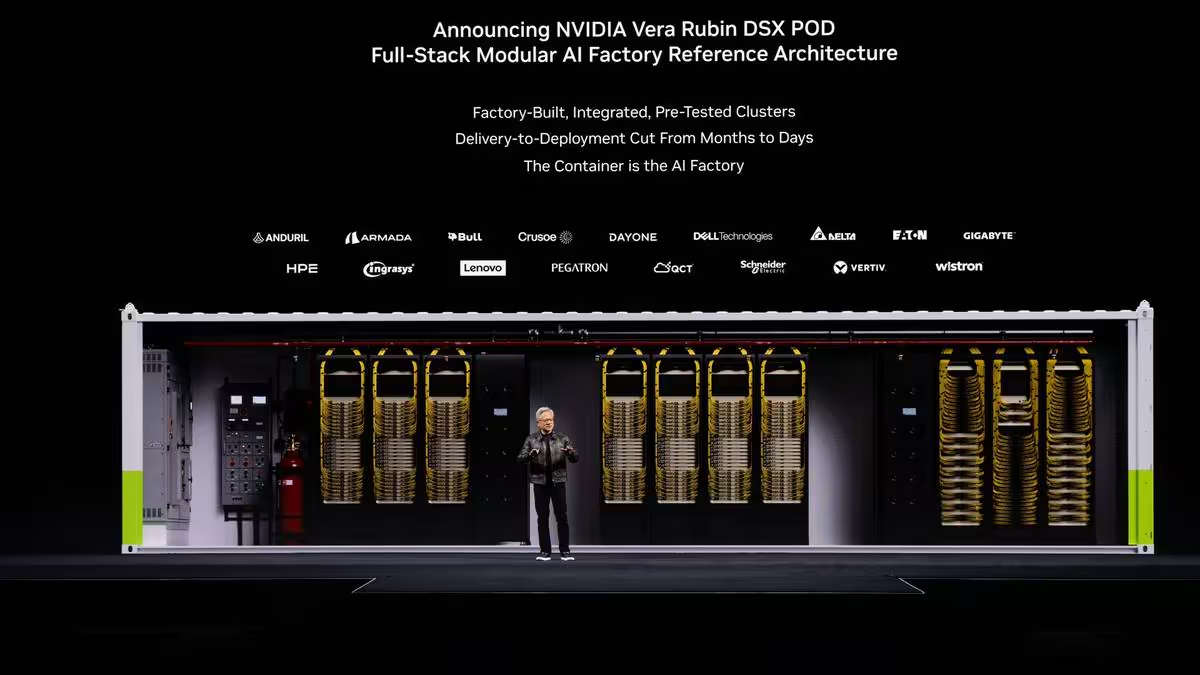
Pour accélérer les déploiements, NVIDIA propose également le design de référence DSX Pod, présenté comme une « usine d’IA » modulaire complète. Le groupe affirme pouvoir réduire à 14 jours une mise en service qui demandait auparavant plusieurs mois.
La difficulté ne réside plus seulement dans la puissance des GPU, mais dans l’énergie, le refroidissement, la mémoire et le transport des données entre accélérateurs. Avec Kyber, NVIDIA pousse donc la logique du système intégré jusqu’au rack complet, tout en faisant de NVLink 7 et du CPO des barrières technologiques aussi stratégiques que le silicium lui-même.
Source : Wccftech

