

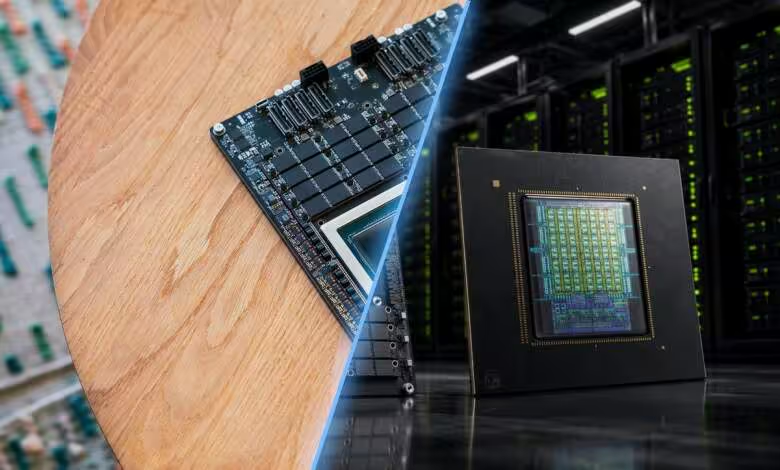
Les agents IA pourraient remettre en cause quinze ans de course au nombre de cœurs dans les serveurs. Pour éviter que ses GPU les plus coûteux attendent le processeur, NVIDIA mise avec Vera sur une architecture monolithique rapide, large et fortement interconnectée.
NVIDIA Vera vise le débit sans sacrifier le monothread
Au début des années 2010, les processeurs de centres de données, notamment les Intel Haswell, privilégiaient un nombre limité de cœurs rapides. L’essor des hyperscalers a ensuite déplacé la priorité vers la densité et la rentabilisation de chaque serveur, favorisant les architectures à chiplets capables d’intégrer davantage de cœurs.
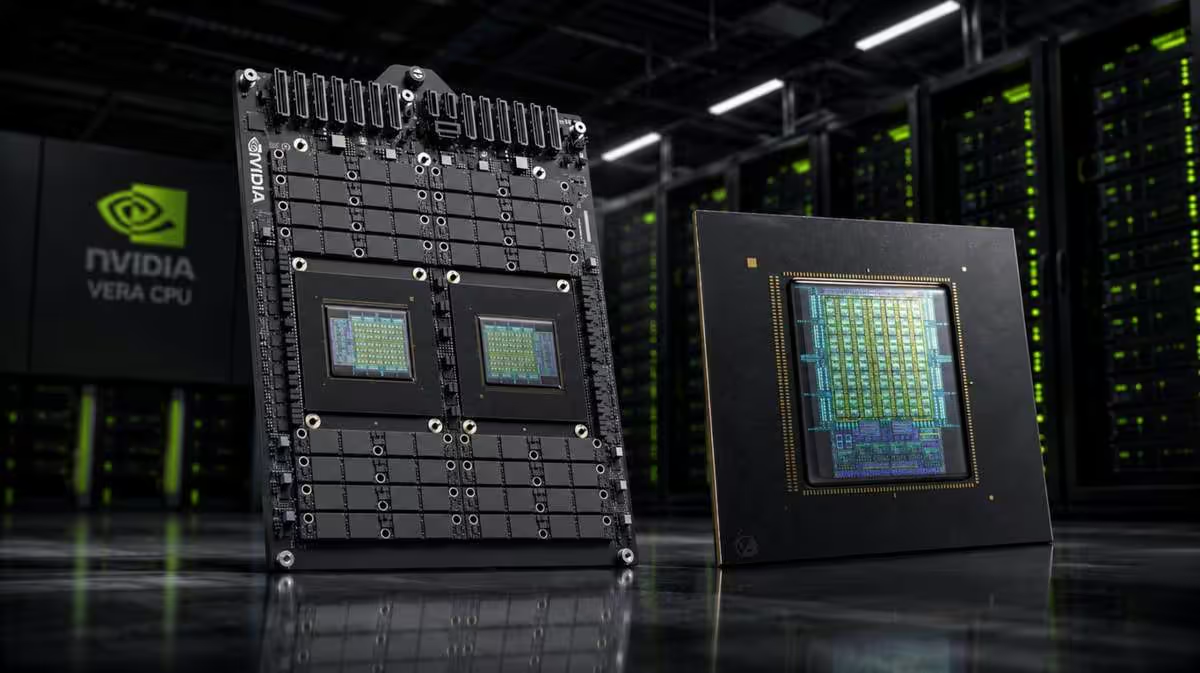
L’équipe Vera estime que ce mouvement s’est fait au détriment de l’IPC et des performances par cœur. Dans un système agentique, le CPU exécute pourtant de nombreuses opérations séquentielles entre deux phases de raisonnement sur GPU. Toute attente côté processeur réduit alors le taux d’utilisation des accélérateurs, qui restent les composants les plus chers d’une usine IA.
Vera doit donc réunir deux qualités longtemps opposées : une forte performance monothread et un débit global élevé. NVIDIA s’appuie pour cela sur ses cœurs Olympus, un sous-système mémoire LPDDR5X personnalisé et la deuxième génération de son Scalable Coherent Fabric.
Le constructeur annonce une performance 1,5 fois supérieure à Grace. Face au meilleur processeur x86 pris comme référence, Vera serait jusqu’à 2 fois plus rapide dans les charges agentiques telles que les scripts Python et la compilation LLVM, avec un avantage de 1,6 fois en moyenne géométrique. NVIDIA n’a toutefois pas répondu précisément à la question portant sur la pénalité de mauvaise prédiction de branchement, malgré un front-end doté d’un décodage sur 10 instructions.
Une puce monolithique pour réduire les échanges coûteux
Contrairement aux conceptions multi-chiplets courantes chez les fabricants x86, Vera regroupe ses cœurs sur un unique die de calcul. Un cœur situé à une extrémité de la puce peut ainsi communiquer avec un autre sans franchir de frontière d’entrée-sortie, ce qui limite les latences lors du partage de contexte et des traitements de données.
NVIDIA revendique une bande passante de bissection de 3,4 To/s, soit trois fois celle du processeur x86 de référence. Ce choix ne constitue cependant pas un rejet définitif des chiplets : l’entreprise affirme qu’elle pourra y revenir si de futurs objectifs techniques ou commerciaux le justifient.
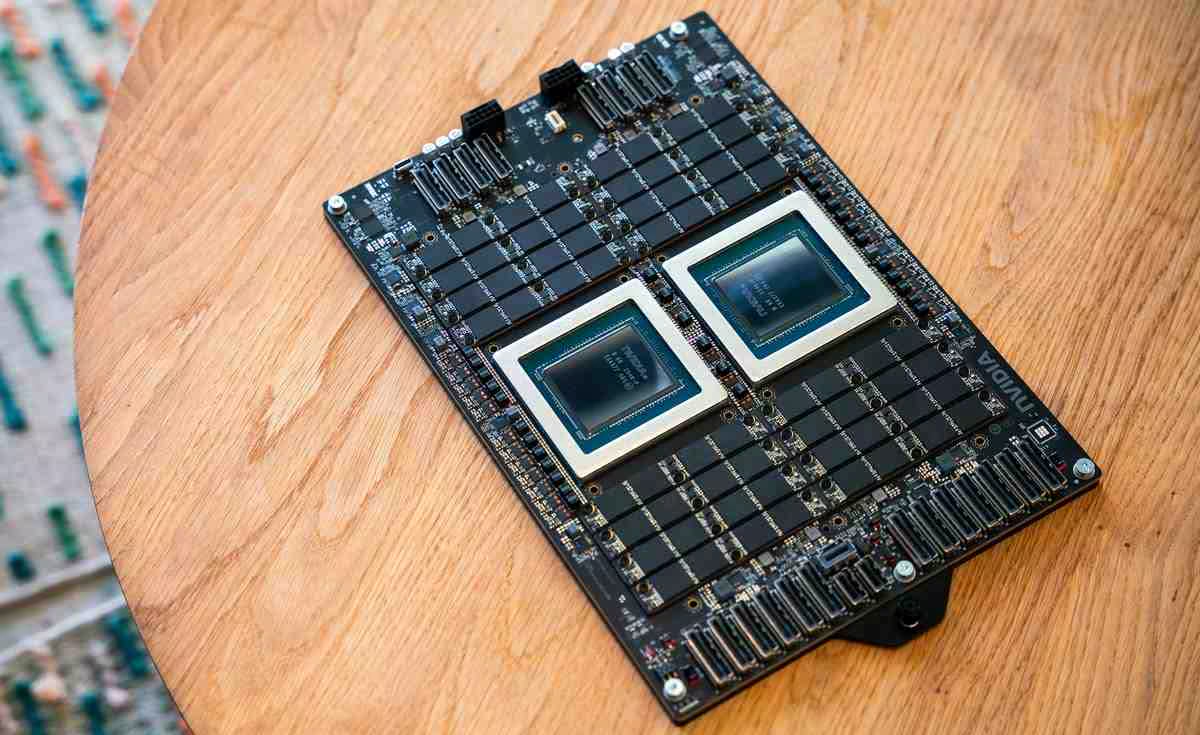
Cette liberté architecturale tient aussi au positionnement de Vera. Intel et AMD doivent décliner leurs architectures sur plusieurs marchés, du PC client au serveur, tandis que NVIDIA dit avoir conçu son CPU exclusivement pour les centres de données hautes performances et l’IA agentique.
Le multithreading spatial sépare calcul et entrées-sorties
Vera emploie par ailleurs un mécanisme propriétaire de multithreading spatial. Il permet d’affecter distinctement un thread aux calculs et un autre aux entrées-sorties, afin que les opérations d’arrière-plan ne privent pas le thread principal de cycles sous forte charge.
NVIDIA affirme que cette organisation n’impose aucune pénalité. L’entreprise cite des mesures de Phoronix faisant état d’un gain d’environ 20 %, sans fournir dans cet échange le détail des conditions ni des charges utilisées.
Des racks de CPU pour les outils des agents IA
Grace avait d’abord été pensé comme un nœud hôte chargé d’alimenter les GPU, selon des configurations de l’ordre de 1 pour 4 ou 1 pour 8 dans un rack. Les appels d’outils des agents et l’apprentissage par renforcement conduisent désormais NVIDIA à envisager Vera comme un processeur autonome, y compris au sein de racks entièrement composés de CPU.
Cette évolution s’inscrit dans une infrastructure IA de plus en plus désagrégée. Les phases de préremplissage et de décodage de l’inférence sont déjà réparties sur des équipements distincts, tandis que certains fournisseurs de sandbox hébergeraient jusqu’à 400 000 environnements pour un seul client. À terme, le marché pourrait devoir gérer des milliers de milliards de sandbox en cours d’exécution.
NVIDIA ne valide pas l’hypothèse d’un ratio de 80 CPU pour 1 GPU, évoquée autour de l’agent Muse de Meta, et refuse d’avancer sa propre projection. Son équipe CPU reconnaît néanmoins que l’équilibre évolue en faveur des processeurs généralistes, ce qui explique la commercialisation envisagée de racks Vera indépendants de la plateforme Vera Rubin.
Le pari monolithique de Vera ne signe donc pas la fin des chiplets, mais souligne une limite de leur usage lorsque la latence inter-cœurs et la vitesse séquentielle priment sur la seule densité. Si les volumes d’appels d’outils annoncés se matérialisent, la compétition dans les serveurs IA ne portera plus uniquement sur les GPU : le CPU redeviendra un levier direct de leur taux d’utilisation.
Source : Wccftech

