

Huit petites stations peuvent désormais agréger 1 To de mémoire unifiée, de quoi accueillir localement des modèles jusqu’ici hors de leur portée. En parallèle, les optimisations logicielles promettent jusqu’à 40 % de performances supplémentaires sur certains workloads d’inférence.
NVIDIA DGX Spark étend ses clusters à huit unités
La plateforme accepte maintenant des clusters manuels de huit systèmes, contre quatre auparavant. Huit modèles dotés de 64 Go peuvent ainsi réunir 512 Go de mémoire, tandis que les configurations de 128 Go culminent à 1 To.
Cette capacité doit permettre d’exécuter de plus grands modèles, d’allonger les contextes et de faire fonctionner plusieurs agents simultanément. NVIDIA cite notamment GLM 5.3 parmi les modèles « frontier-class » accessibles avec 1 To de mémoire.
Une version 64 Go attendue le 23 octobre
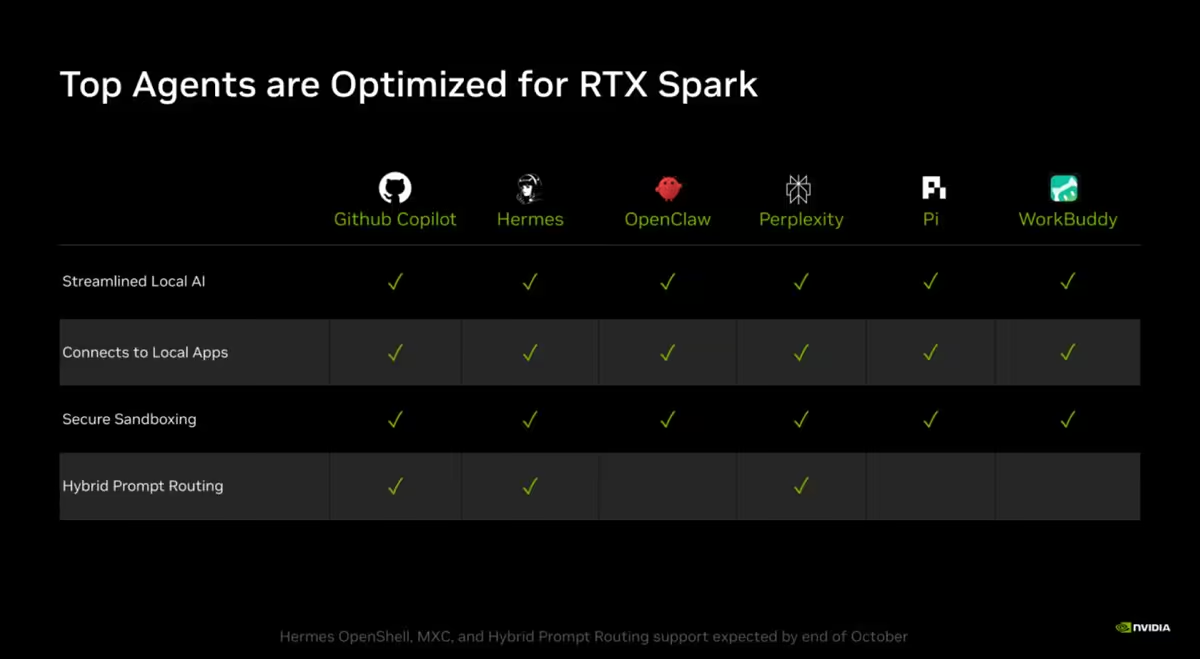
Le DGX Spark 64 Go doit arriver le vendredi 23 octobre. Cette capacité convient notamment au Nemotron 3.5 Bolt 74B 24GB, ainsi qu’aux modèles Qwen3.8 27B et Gemma 4 26B-A4B.
NVIDIA Sync Model Launcher est également prévu plus tard dans le mois. Depuis une machine seule ou un cluster, l’outil téléchargera un modèle et son conteneur adaptés à la configuration, puis assurera la connexion à OpenCode. Il chargera automatiquement les DGX Spark Skills destinés au dépannage, à la maintenance, à la consultation de la documentation officielle et à l’accompagnement des workflows.
La mise à jour logicielle d’octobre ajoutera aussi Wi-Fi Assistant, afin de changer de réseau lorsque le système fonctionne en mode appliance. Les DGX Spark Skills intégreront directement dans NVIDIA Sync, via OpenCode, des procédures de maintenance et de diagnostic.
Des modèles locaux plus rapides et moins gourmands
Recursive Flint rejoint RTX Spark avec des poids ouverts et une optimisation spécifique au matériel local NVIDIA. Ce modèle de code MoE de 40 milliards de paramètres n’en active que 2,5 milliards et dépasserait 220 tokens par seconde sur un système RTX Spark équipé de 64 Go.
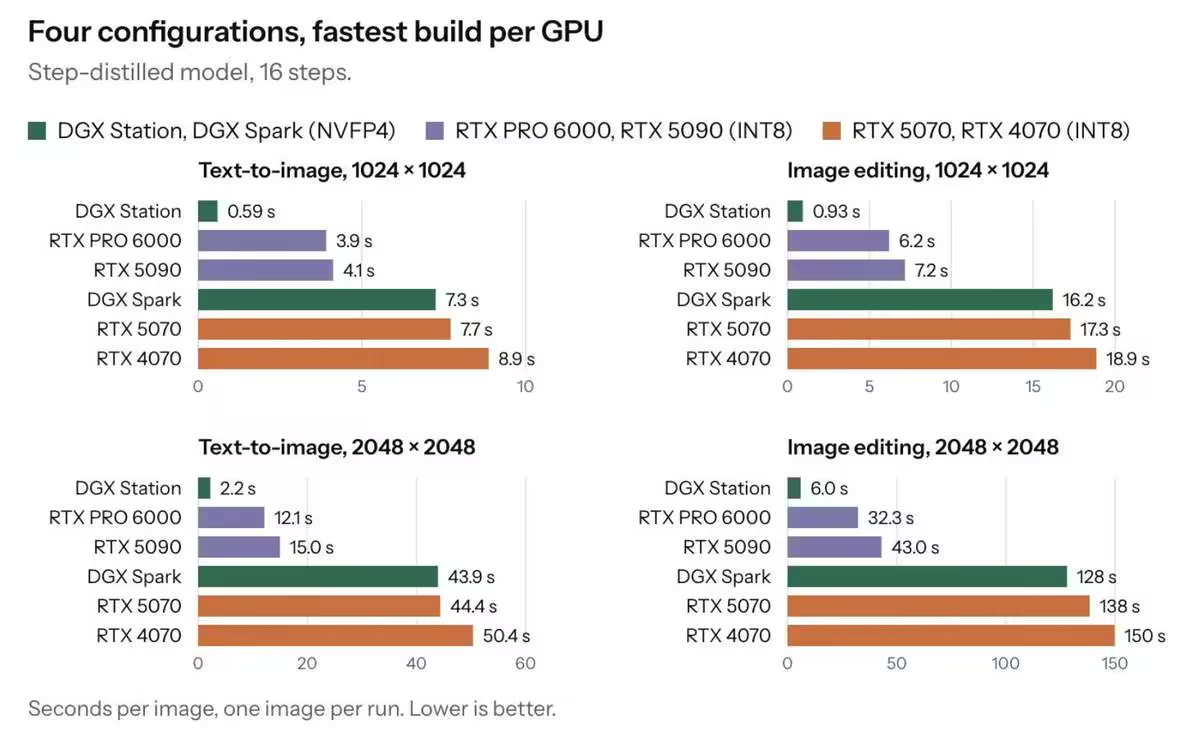
Le support dès leur sortie s’élargit également à Nemotron Bolt E4B 4B, GLM, DeepSeek, Qwen, MiniMax M3.1 et FLUX.3 Klein. Ces modèles couvrent les agents locaux, la programmation, la génération d’images et leur édition.
Une nouvelle collection de checkpoints quantifiés vise à réduire l’occupation en RAM tout en restant proche de la précision complète. L’espace libéré peut être consacré au cache KV et, par conséquent, à des contextes plus longs. Qwen3.8-Flash-Next-FP4-Local fonctionne sur un seul DGX Spark 128 Go ou une RTX PRO 6000, tandis que GLM-5.3-Flash-FP4-Local demande deux systèmes.
Jusqu’à 40 % de mieux avec vLLM et llama.cpp
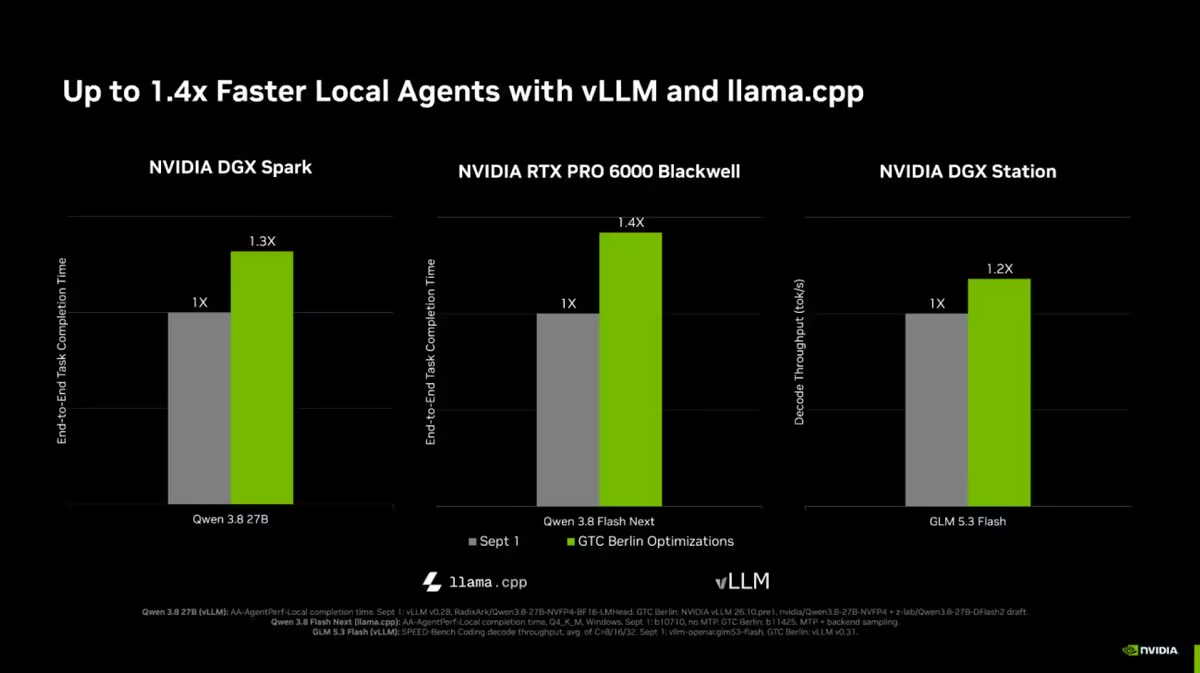
Le travail mené avec les communautés open source de vLLM et llama.cpp produit des gains variables selon le modèle et la plateforme. NVIDIA mesure une progression de 30 % pour Qwen 3.8 27B sur DGX Spark, de 20 % pour GLM 5.3 Flash sur DGX Station et de 40 % pour Qwen 3.8 Flash-Next sur RTX PRO 6000 Blackwell.
Underdog Desktop Agent arrive par ailleurs sur RTX Spark et conserve les modèles comme les données personnelles sur la machine. NVIDIA Cloud Functions doit entrer en accès anticipé sur DGX Station afin de partager des endpoints locaux derrière une interface commune et de remplacer le modèle sous-jacent sans modifier le code applicatif.
DGX Station bénéficie aussi de sept intégrations de gestion pour les entreprises : Absolute Security, Splunk by Cisco, Fleet Device Management, Microsoft Intune, Perforce Puppet, Progress Software Chef et Tanium. La déclinaison Windows est annoncée pour décembre, avec la prise en charge d’applications industrielles et d’environnements d’agents pour la conception, la simulation, la validation et l’automatisation d’ingénierie.
Trois workflows robotiques open source complètent cette offensive. Ils serviront à affiner des modèles de robots, entraîner des compétences de manipulation fine et post-entraîner des world models destinés à produire des données synthétiques.
L’intérêt du cluster à huit nœuds tient moins à sa puissance brute qu’à sa capacité mémoire agrégée. NVIDIA transforme ainsi DGX Spark en solution de développement distribuée, mais l’efficacité réelle dépendra fortement des interconnexions, de la parallélisation des modèles et du surcoût logiciel face à une station monolithique.
Source : Wccftech

