

Quelques micromètres plutôt que quelques centimètres : rapprocher les données du calcul est désormais une réalité dans les laboratoires de San Diego. Reste à porter cette architecture sur une carte d’inférence, avec une promesse d’efficacité énergétique nettement supérieure à celle de la HBM actuelle.
HBC passe les tests de lecture, d’écriture et de calcul
Qualcomm a validé sur silicium sa première génération de High Bandwidth Compute (HBC), dont le concept avait été présenté cet été. Les essais réalisés dans son laboratoire de San Diego couvrent la lecture, l’écriture et le calcul à proximité de la mémoire. Une étape concrète pour une technologie destinée à l’inférence IA.
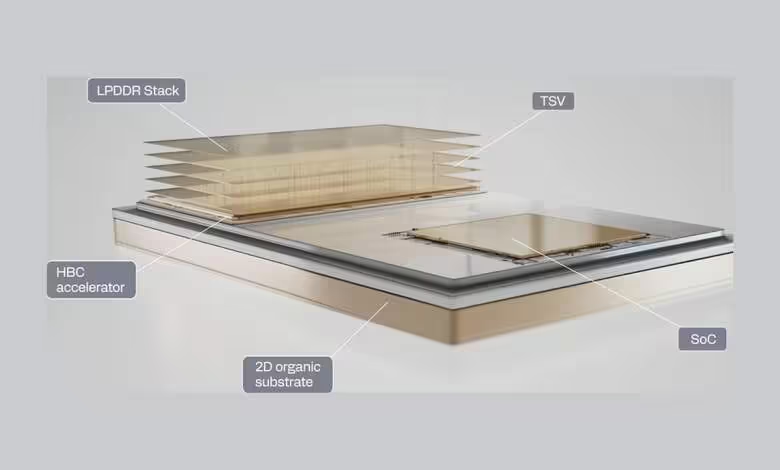
Au lieu d’associer une mémoire HBM traditionnelle à des puces de calcul distinctes, Qualcomm empile plusieurs couches de LPDDR en 3D, reliées par des vias traversants, ou TSV. À la base, une puce de calcul assure le traitement au plus près des données, avec une répartition des opérations vers les dies de proximité mémoire.
Le choix de la LPDDR constitue l’autre particularité de cette approche. Là où la HBM empile de la DDR classique, Qualcomm utilise des puces basse consommation pour obtenir une bande passante et une capacité comparables, tout en réduisant les besoins énergétiques.
Le principe présente des similitudes avec la HBM4, dont le die de base logique permet de mieux intégrer des fonctions de suivi des paquets et de préparation des données en entrée comme en sortie de mémoire. Qualcomm pousse toutefois plus loin le rapprochement entre stockage et traitement : le calcul doit prendre place directement sous les piles, afin de limiter les déplacements à quelques micromètres.
133 To/s pour l’ensemble de l’AI250
Qualcomm revendique une bande passante par watt multipliée par six face à la spécification HBM actuelle. Ce gain annoncé repose à la fois sur la consommation de la LPDDR et sur une circulation des données plus courte et mieux optimisée.
Avec HBC Gen 1, la bande passante mémoire totale atteint 133 To/s sur la carte accélératrice AI250, soit 18 fois celle de la LPDDR5X utilisée sur l’AI200 de Qualcomm. Ce chiffre concerne bien l’ensemble de l’accélérateur, et non un module HBC pris isolément.
Les premiers exemplaires de HBC Gen 1 sont attendus avec l’AI250 au premier semestre 2027. Qualcomm indique également disposer d’une feuille de route permettant d’étendre cette technologie à plusieurs de ses accélérateurs IA.
La validation sur silicium établit le fonctionnement de l’architecture, mais ne mesure pas encore son bénéfice à l’échelle d’une charge d’inférence complète. L’enjeu sera de traduire cette bande passante et ces déplacements réduits en débit utile, sans que les autres étapes du traitement deviennent le nouveau goulot d’étranglement.
Source : Qualcomm

