

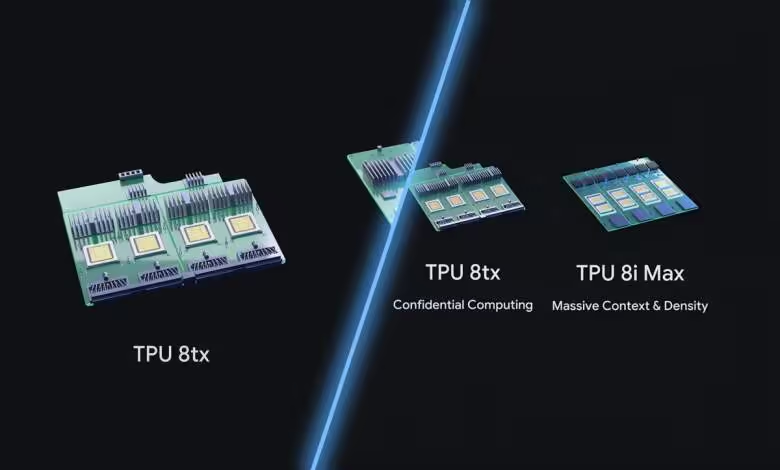
Protéger les modèles pendant leur exécution et alimenter des contextes d’un million de tokens réclament deux réponses matérielles différentes. Le géant de Mountain View élargit donc sa huitième génération d’accélérateurs, avec un retour au x86 pour l’une des variantes et un assemblage à deux puces pour l’autre.
TPU 8tx : des hôtes AMD pour le calcul confidentiel
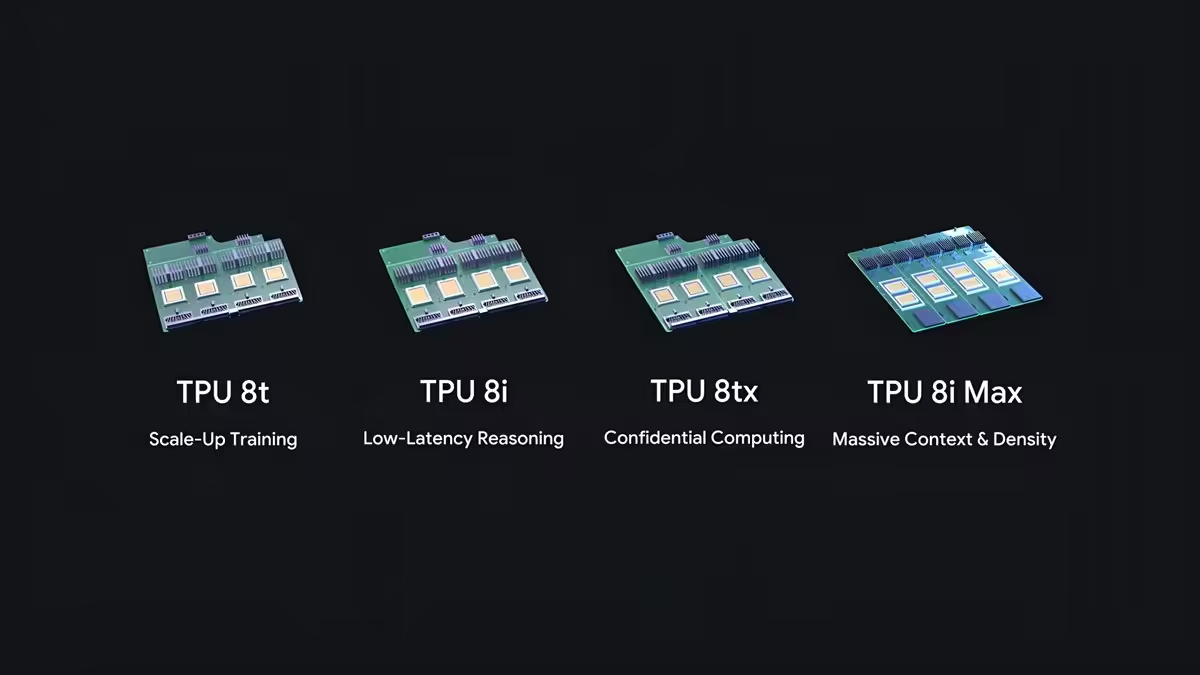
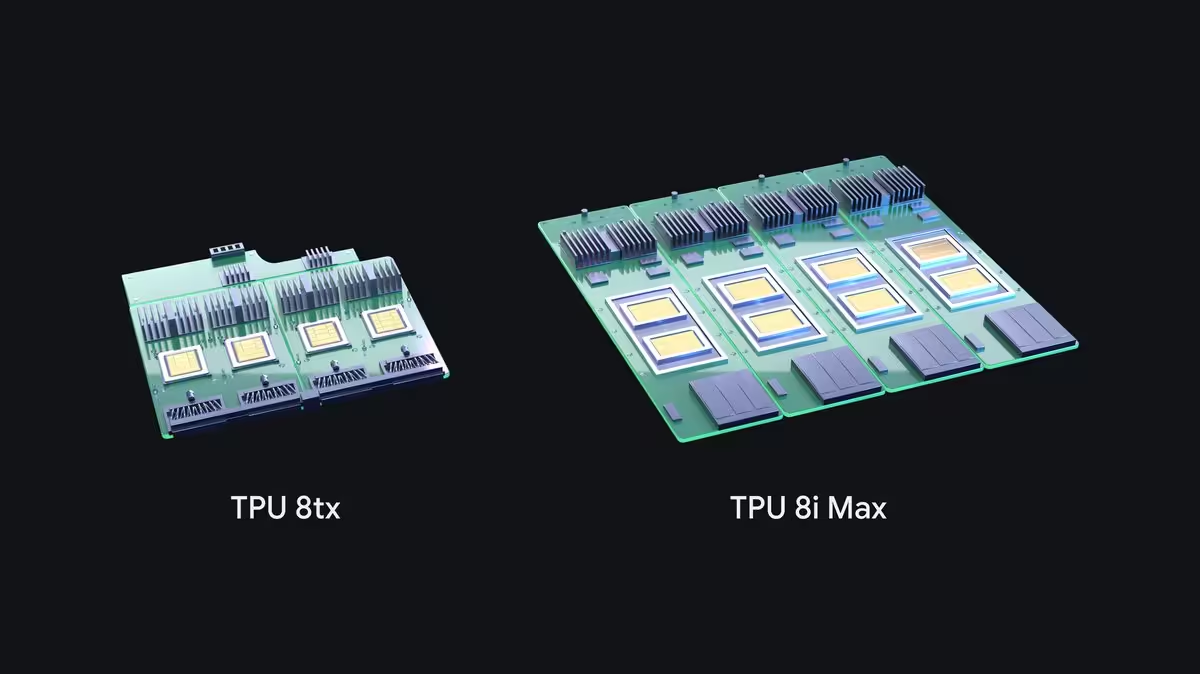
Google ajoute les TPU 8tx et TPU 8i Max à sa famille TPU v8, portant à quatre le nombre de nouveaux TPU introduits sur une même année, une première pour l’entreprise. Les deux déclinaisons visent les charges d’IA agentique, mais empruntent des voies distinctes : le 8tx dérive du TPU 8t, tandis que le 8i Max réunit deux TPU 8i dans un seul package.
Le TPU 8tx associe le silicium du 8t à des processeurs hôtes AMD EPYC personnalisés, là où les plateformes 8t et 8i utilisent les CPU Arm Axion de Google. Cette combinaison apporte un calcul confidentiel assuré au niveau matériel, destiné à protéger les données et les poids des modèles pendant leur traitement. Elle cible l’inférence confidentielle, les agents et l’entraînement à petite échelle.
Le 8tx reprend également le réseau Boardfly développé pour le TPU 8i. Google revendique des performances jusqu’à deux fois supérieures à celles du TPU 8t avec l’ensemble de ces modifications, et une pénalité de performances presque nulle liée aux fonctions de sécurité renforcées. Ce gain reste une annonce du constructeur, sans mesure indépendante présentée dans la source.
Le TPU 8i Max double pour sa part le calcul, la SRAM et la bande passante HBM du TPU 8i, selon Google. Son assemblage à deux puces porte la SRAM à 768 Mo et conserve un encombrement en rack approximativement identique, ce qui revient à doubler la densité de calcul. La capacité HBM totale n’est toutefois pas confirmée : le doublement de la bande passante ne constitue pas une annonce de capacité.
Cette déclinaison vise les besoins mémoire des agents et des contextes atteignant un million de tokens. Pour comprendre ce que ces variantes changent, il faut revenir aux deux architectures dont elles sont issues : le 8t privilégie l’entraînement, le 8i l’inférence.
La séparation entre les TPU 8i dédiés à l’inférence et 8t orientés entraînement éclaire l’origine technique des deux nouvelles variantes annoncées par Google : les architectures TPU 8i et 8t de Google en détaillent les rôles respectifs.
Le 8t, une base d’entraînement à 12,6 PFLOPS en FP4
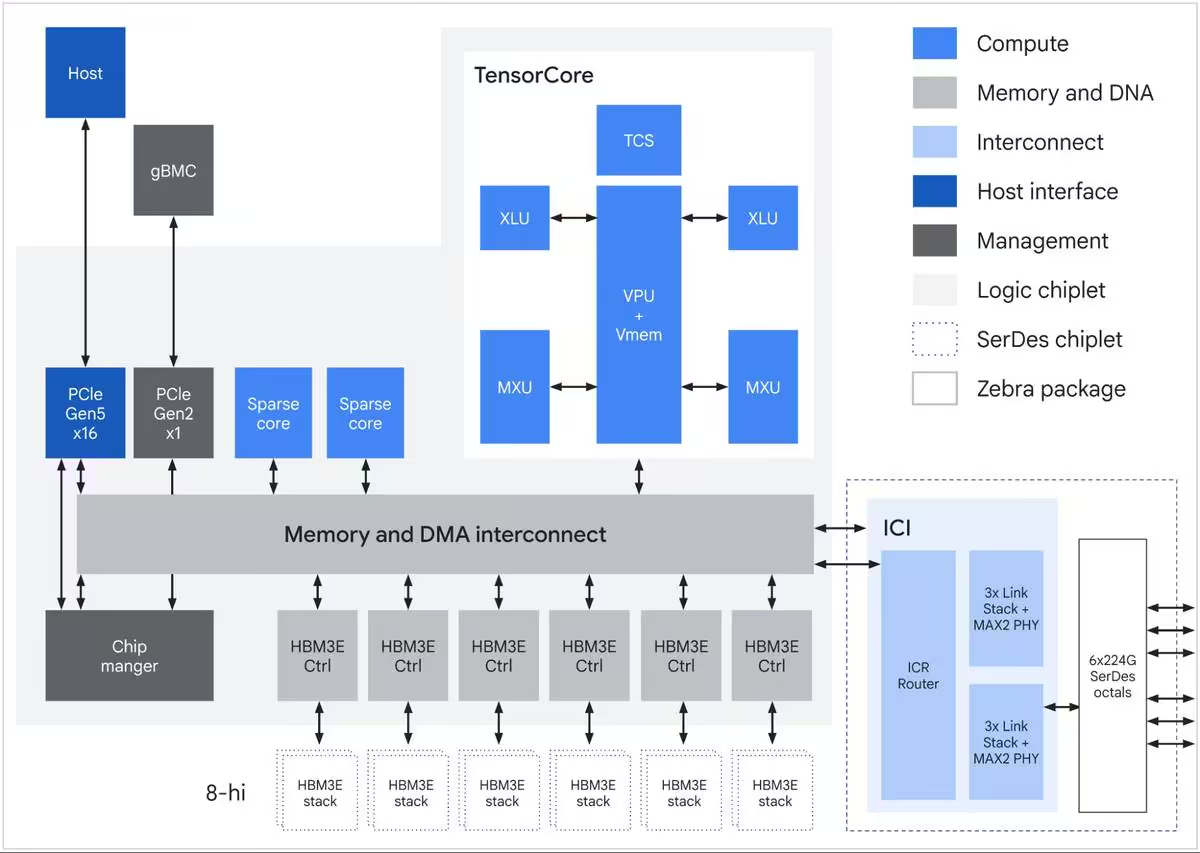
Le TPU 8t utilise un package « Zebra », réunissant un chiplet logique central, un chiplet SerDes distinct et plusieurs piles de mémoire à haute bande passante. Son TensorCore articule une unité vectorielle VPU et sa mémoire Vmem avec deux unités de multiplication matricielle MXU, deux unités logiques étendues XLU et un bloc Tensor Core System, ou TCS.
Les MXU prennent nativement en charge le FP4, doublant le débit pour atteindre 12,6 PFLOPS par puce, tout en limitant les déplacements de données énergivores. Le dimensionnement conjoint des VPU et des MXU permet de faire chevaucher les opérations vectorielles, comme softmax, et les multiplications matricielles. Deux Sparse cores prennent aussi en charge les accès mémoire irréguliers dépendant des données, notamment les recherches dans les tables d’embeddings.
Un interconnect « Memory and DMA » relie les unités de calcul à six contrôleurs HBM3E, chacun associé à une pile HBM3E 8-hi dans le package. Les spécifications publiques indiquent entre 216 et 288 Go de mémoire par puce, pour une bande passante comprise entre 6,5 et 8,6 To/s. À cela s’ajoutent 128 Mo de SRAM intégrée au die, pour conserver certaines données au plus près du calcul.
L’interconnexion ICI comprend un routeur ICR et deux blocs « 3x Link Stack + MAX2 PHY ». Elle rejoint le chiplet SerDes, équipé de six octets SerDes à 224 Gbit/s. Côté hôte, le chiplet logique dispose d’une liaison PCIe Gen5 x16, complétée par un PCIe Gen2 x1 vers le gBMC ; un bloc « Chip manager » supervise les opérations de la puce.
Dans les systèmes TPU 8t, les processeurs Axion assurent notamment le prétraitement des données. Leur rôle consiste à alimenter les accélérateurs sans que la latence côté hôte ne devienne le facteur limitant.
Le 8i privilégie la mémoire et le débit d’inférence
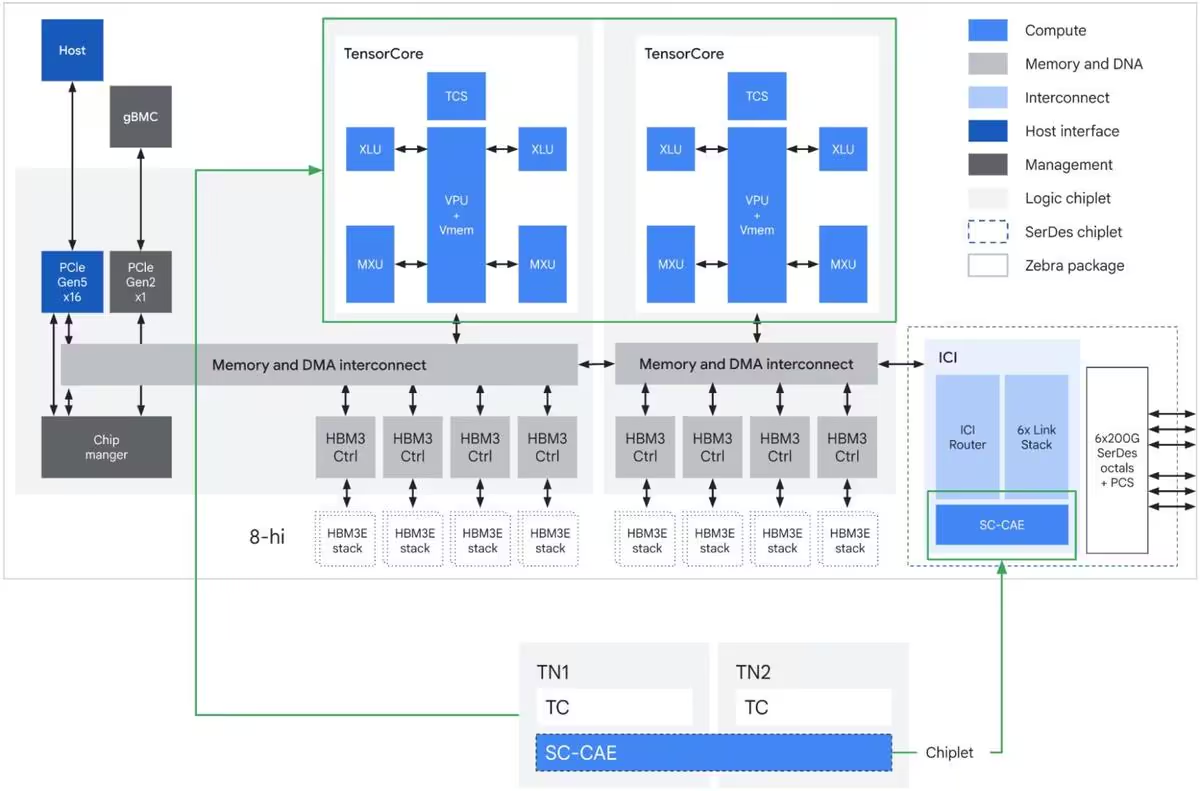
Le TPU 8i conserve le package Zebra et la séparation entre logique et SerDes, mais embarque deux TensorCores. Chacun possède une VPU avec Vmem, deux MXU, deux XLU et un bloc TCS. Cette configuration atteint une puissance de crête annoncée de 10,1 PFLOPS en FP4.
Le sous-système mémoire repose sur deux interconnects « Memory and DMA », chacun desservant quatre contrôleurs HBM3. Ces huit contrôleurs sont reliés à huit piles HBM3E 8-hi intégrées au package. Au total, le TPU 8i dispose de 288 Go de HBM3E à 8,6 To/s et de 384 Mo de SRAM sur la puce, notamment pour conserver du cache KV actif et éviter des accès à la RAM système.
Les serveurs TPU 8i remplacent les processeurs hôtes x86 par les Axion Arm de Google, associés à de la DDR5 pour les tâches côté hôte, dont le prétraitement. Les communications utilisent là encore un PCIe Gen5 x16 vers l’hôte et un PCIe Gen2 x1 vers le gBMC, sous la supervision d’un « Chip manager ».
Le module ICI du 8i intègre un routeur ICI, un « 6x Link Stack » et un bloc SC-CAE. Son chiplet SerDes externe rassemble six octets SerDes à 200 Gbit/s et une sous-couche PCS, chargée du codage physique des communications hors puce sur les topologies de Google.
Avec le 8i Max, Google augmente donc simultanément les ressources de calcul et les moyens de les alimenter, plutôt que de relever uniquement un chiffre de puissance. L’intérêt pour les longs contextes dépendra néanmoins aussi de la capacité HBM effectivement disponible et de la répartition du travail entre les deux puces, deux éléments que le seul doublement des débits ne permet pas de quantifier.
Source : Wccftech

