

Les appels d’outils et les requêtes SQL peuvent faire attendre des GPU pourtant taillés pour le raisonnement. C’est sur ces étapes d’exécution que le concepteur de GeForce entend imposer son processeur serveur, avec des gains annoncés aussi bien en rapidité qu’en efficacité énergétique.
NVIDIA Vera face à deux profils d’EPYC Venice
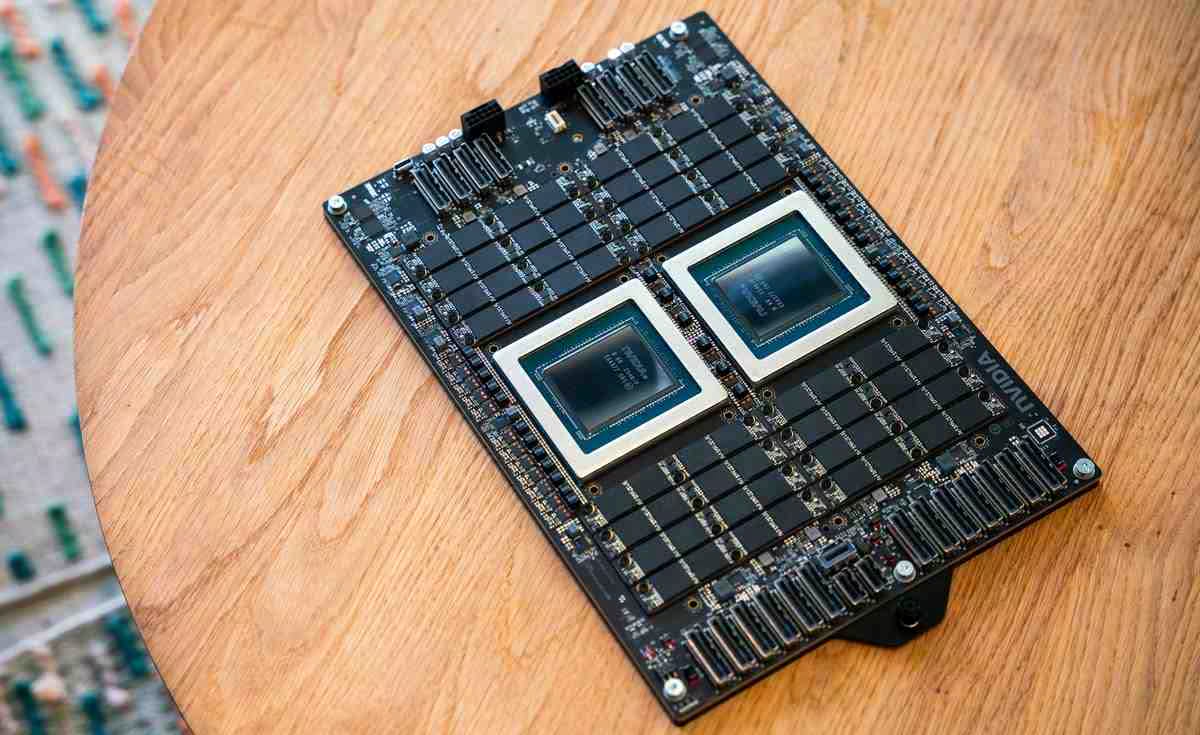
NVIDIA publie de nouvelles comparaisons avec les AMD EPYC Venice de 6e génération. Face à la version à 96 cœurs optimisée pour la fréquence, Vera afficherait 1,6 fois plus d’agents par watt, soit un avantage de 60 %. Face au modèle Zen 6 à 256 cœurs, le constructeur revendique une vitesse d’exécution des agents doublée.
Ces deux résultats ne mesurent donc pas exactement la même chose : le premier porte sur l’efficacité énergétique, le second est présenté comme un gain de vitesse. Wccftech associe toutefois aussi ce dernier aux « tâches par MW », ce qui laisse le périmètre précis de la mesure à clarifier. Les chiffres proviennent de NVIDIA et mériteraient un détail des configurations et du protocole pour être pleinement exploitables.
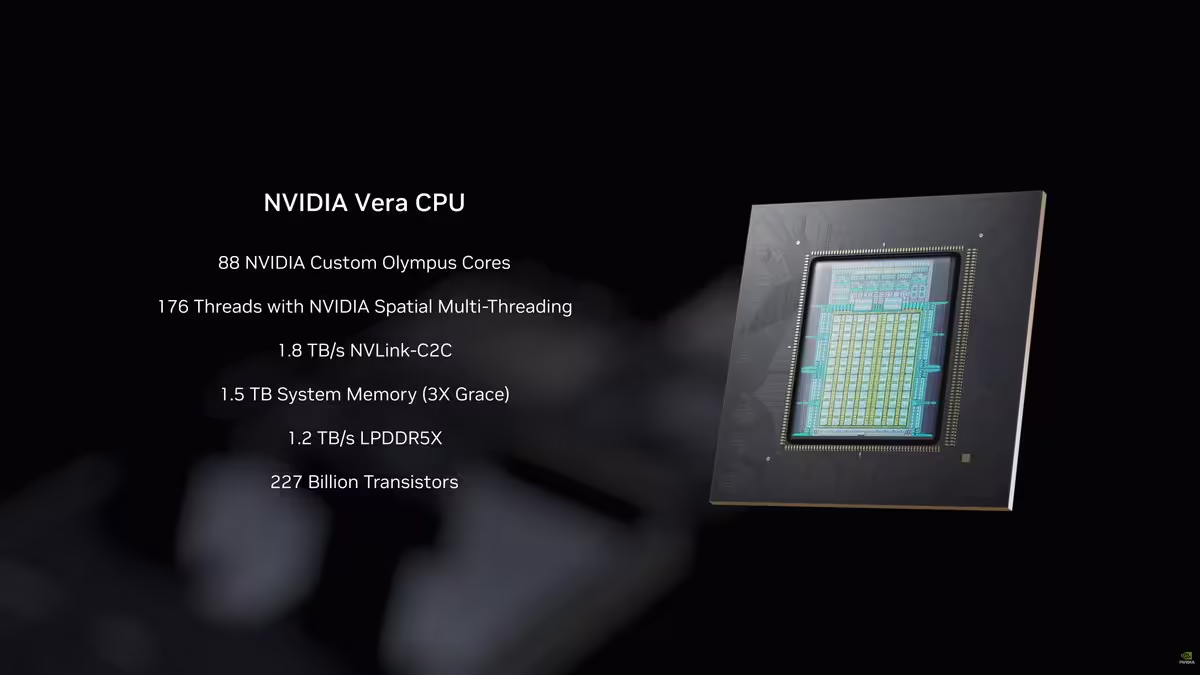
Vera embarque 88 cœurs Olympus personnalisés et 176 threads grâce au NVIDIA Spatial Multi-Threading. La présentation indique une liaison NVLink-C2C à 1,8 To/s, jusqu’à 1,5 To de mémoire système, soit trois fois la capacité de Grace, et une bande passante LPDDR5X de 1,2 To/s. Elle mentionne également 227 milliards de transistors.
Ces choix répondent aux contraintes des charges agentiques : une tâche peut enchaîner des centaines d’allers-retours entre GPU et CPU. Le premier assure le raisonnement, tandis que le second exécute les appels d’outils, les requêtes SQL, les appels d’API et les scripts. Ces étapes séquentielles sollicitent fréquemment la mémoire : performances par cœur, bande passante et latence conditionnent le délai avant la reprise du calcul sur GPU.
Des essais chez Perplexity, DeepInfra et les fournisseurs de sandboxes
Les résultats relayés ne se limitent pas aux comparaisons avec Venice. Perplexity rapporte des tâches de programmation agentique exécutées 1,5 fois plus vite que sur des CPU traditionnels et prévoit de déployer Vera dans un prochain système de production. DeepInfra annonce jusqu’à 2,2 fois les performances de la meilleure solution x86 sur sa propre charge d’orchestration d’agents en production, Vera terminant en tête des quatre architectures testées.
Sur les bases de données, ClickHouse rapporte une montée en charge presque linéaire avec son binaire standard, sans optimisation spécifique à Vera, jusqu’aux 176 unités d’exécution évoquées dans les résultats. Le processeur prend la tête du classement matériel ClickBench. DuckDB obtient pour sa part environ 1,5 fois la performance médiane d’une plateforme Intel Xeon 6 sur TPC-H SF1000.
Daytona met en ligne 1 000 sandboxes d’agents en 10,8 secondes. Avec 2 000 environnements simultanés, la plateforme termine 12,7 travaux par seconde, contre 10,9 sur AMD EPYC 9755. Chez Modal, le débit des sandboxes par cœur atteint jusqu’à deux fois celui de matériels x86 comparables, avec un écart qui augmente sous forte charge.
L’intérêt de ces résultats tient au coût des étapes séquentielles : multiplier les cœurs ne suffit pas si chaque appel d’outil retarde le raisonnement suivant. Pour les exploitants, la comparaison utile devra donc porter sur la tâche complète et la consommation de la plateforme, plutôt que sur le seul débit CPU. C’est à cette échelle que les gains revendiqués pourront justifier un changement d’architecture.
Source : Wccftech

