


Revenir sur ses pas et retrouver la même rue : ce geste banal reste un défi pour les mondes générés par IA. Une nouvelle recherche permet de conserver la cohérence des lieux parcourus, plutôt que de les réinventer à chaque passage.
Développé par le Spatial Intelligence Lab (SIL) de NVIDIA, Lyra 2.0 associe génération vidéo et reconstruction 3D pour transformer une photographie en environnement explorable. Les travaux, publiés en avril 2026, sont désormais mis en avant par NVIDIA à l’approche du SIGGRAPH Asia 2026.
Lyra 2.0 garde une mémoire des lieux déjà générés
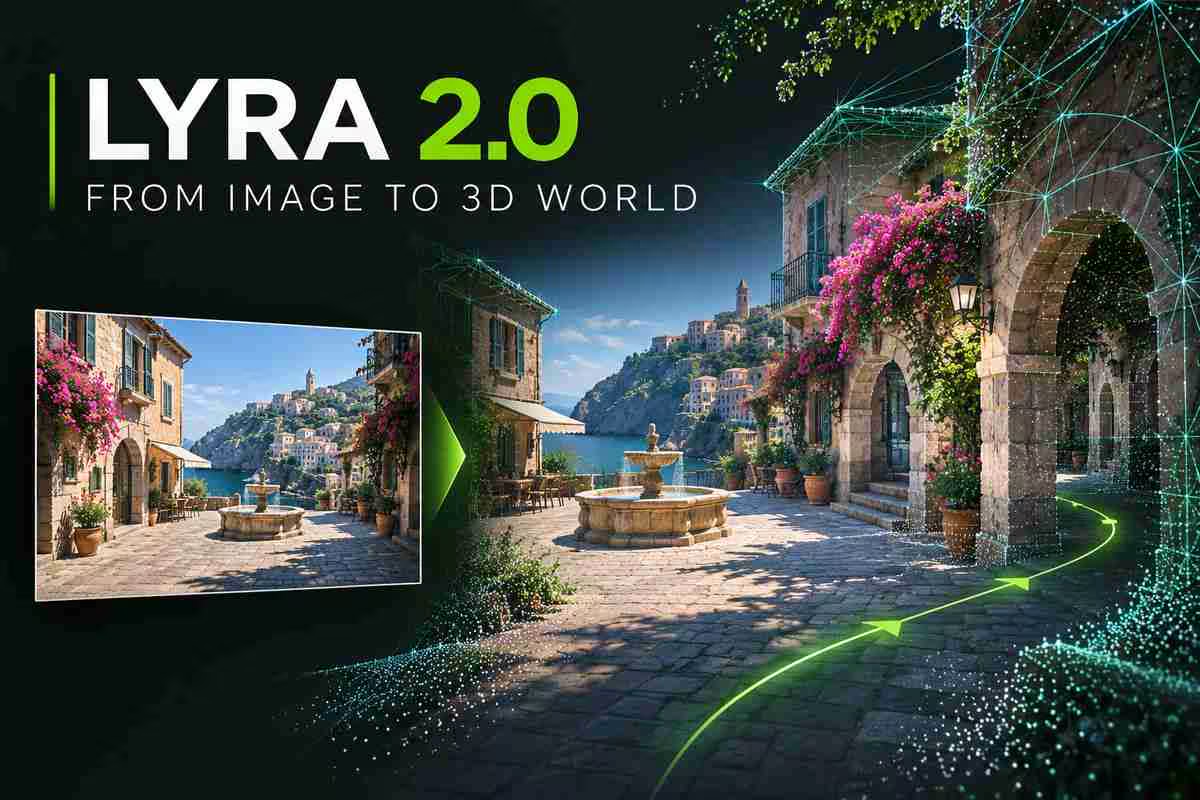
Contrairement à un générateur image-vers-vidéo produisant une séquence prédéterminée, le système permet de contrôler la trajectoire de la caméra. Il génère progressivement de nouvelles vues au-delà du cadre initial, tout en cherchant à maintenir la cohérence de l’environnement.
Deux difficultés se posent sur ces parcours prolongés. L’oubli spatial conduit le modèle à perdre la trace des lieux déjà créés, avec des structures susceptibles de changer lorsqu’on y revient. La dérive temporelle, elle, correspond à l’accumulation d’erreurs visuelles et géométriques au fil de la génération.
La réponse des chercheurs repose sur une mémoire spatiale guidée par la géométrie 3D, qui retrouve les images pertinentes parmi les vues précédemment générées. Le modèle est également entraîné sur ses propres sorties imparfaites : l’objectif est de lui apprendre à corriger les erreurs accumulées, plutôt qu’à les amplifier.
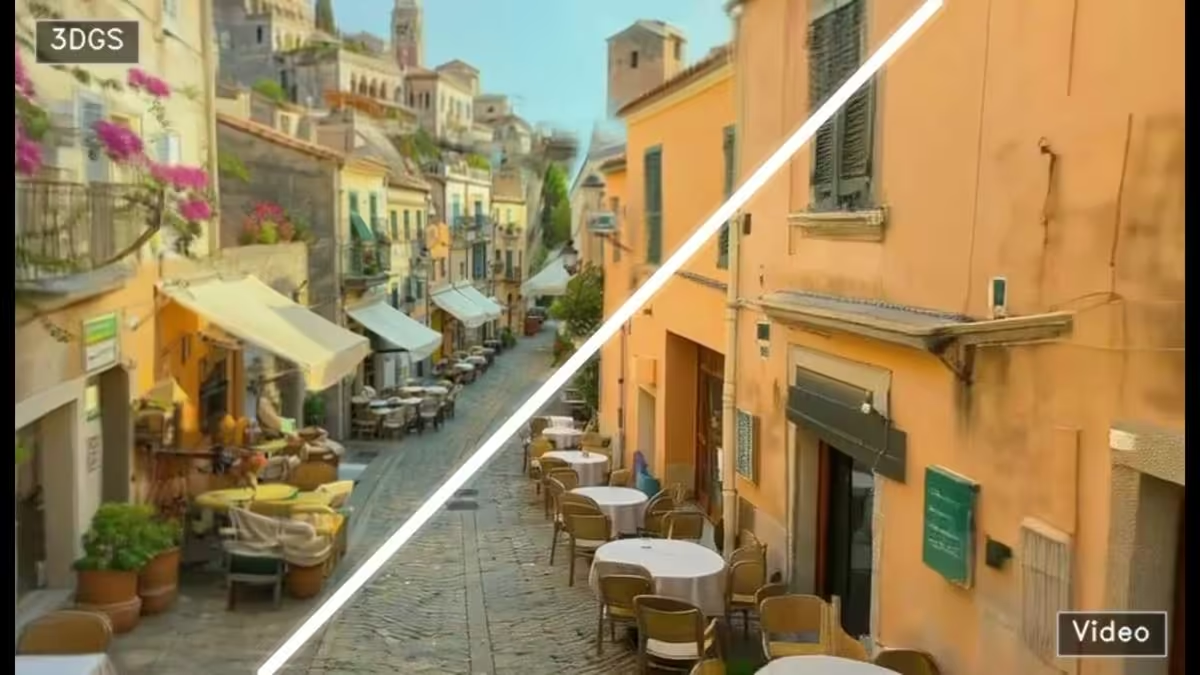
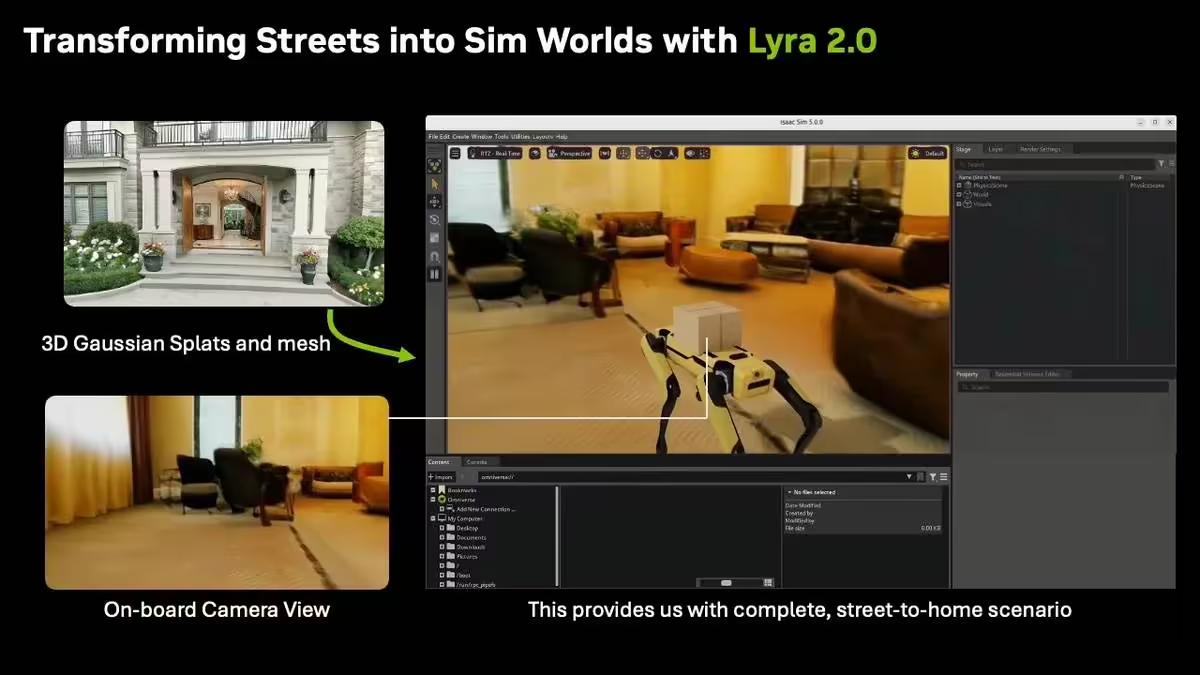
Ces séquences vidéo peuvent ensuite être reconstruites sous forme de 3D Gaussian Splats et de maillages polygonaux. Cette représentation explicite autorise un rendu depuis différents points de vue, en temps réel, ainsi que l’export vers des applications comme NVIDIA Isaac Sim. La démonstration présente notamment un environnement importé dans Isaac Sim 5.0 pour la simulation robotique.
15 secondes sur GB200 pour générer 80 images
Le rendu du décor reconstruit et sa génération sont toutefois deux opérations distinctes. Lyra 2.0 ne génère pas ses mondes en temps réel, même si NVIDIA a nettement réduit le coût de calcul de la génération vidéo.
Une version distillée du modèle passe de 35 à 4 étapes de débruitage, pour un temps de génération réduit d’environ un facteur 13. D’après les mesures de l’article de recherche, un segment de 80 images demande environ 15 secondes sur un seul GPU NVIDIA GB200, contre 194 secondes avec le modèle complet.
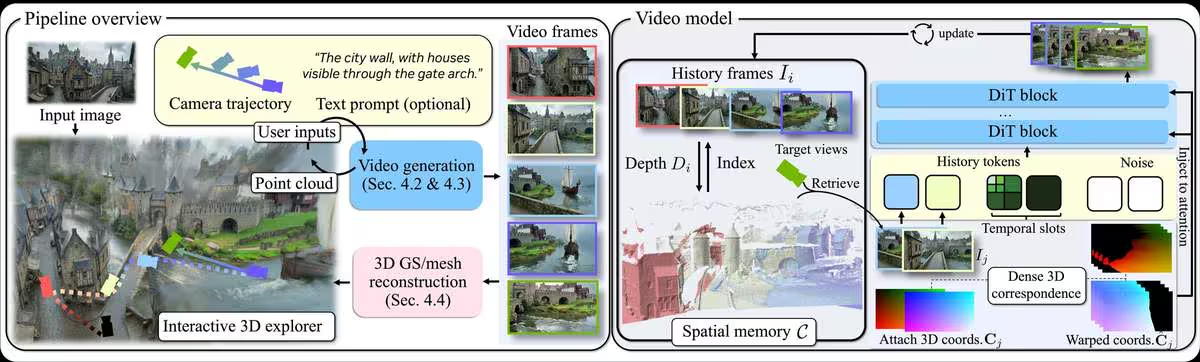
Le système reste par ailleurs adapté à des environnements essentiellement statiques. La génération de scènes dynamiques demeure difficile, et des incohérences visuelles peuvent encore apparaître. La mémoire spatiale améliore donc la continuité des parcours sans éliminer tous les défauts.
Les débouchés envisagés concernent le développement de jeux vidéo, la réalité virtuelle et la simulation robotique. Là où le Project Genie de Google expérimente lui aussi des mondes virtuels explorables, l’approche de NVIDIA se distingue par la reconstruction du contenu généré en géométrie 3D explicite, réutilisable dans un environnement de simulation.
L’implémentation est disponible sur GitHub, tandis que les poids sont proposés sur Hugging Face. Ces derniers restent soumis aux restrictions de la licence NVIDIA destinée à la recherche : cette mise à disposition ne vaut donc pas autorisation générale d’exploitation commerciale.
Pour les studios, l’intérêt immédiat tient moins à la promesse d’un jeu complet issu d’une photographie qu’à la récupération d’un décor exploitable hors du générateur. Le passage à une représentation 3D explicite est décisif sur ce point, mais les temps de calcul, les défauts résiduels et la gestion des éléments dynamiques restent des contraintes avant d’en faire un outil de production.
Source : Wccftech

