

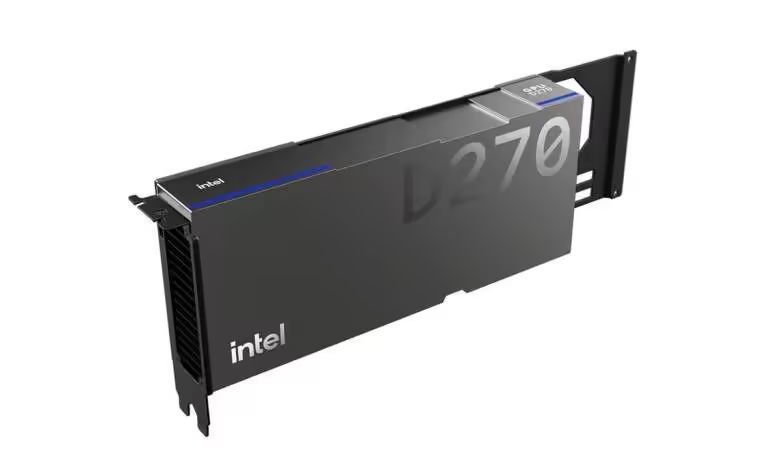
La capacité mémoire du nouvel accélérateur d’Intel pourrait dépasser la limite officiellement accordée aux partenaires. Une configuration de 512 Go est évoquée, mais elle cadre difficilement avec le PCB connu de Crescent Island.
Intel GPU D-Series : une capacité de 512 Go encore incertaine
Le leaker Haze affirme dans une publication datée du 13 octobre, repérée par VideoCardz, que certaines versions conçues par les partenaires embarqueraient jusqu’à 512 Go de mémoire. Aucun fabricant ni détail technique supplémentaire n’est cité, tandis qu’Intel n’a pas confirmé cette capacité.
La carte D-Series de référence, auparavant connue sous le nom de « Crescent Island », dispose officiellement de 160 Go de LPDDR5X. Intel permet à ses partenaires de monter jusqu’à 480 Go.
Le PCB apparu en fuite en mai comptait 20 emplacements LPDDR5X, dont 12 sur la face avant et huit au dos. Avec des puces de 8 Go, cette implantation produit précisément 160 Go ; des modules de 24 Go permettent d’atteindre 480 Go, alors que 512 Go ne se répartissent pas uniformément sur ces 20 emplacements.
Un accélérateur Xe3P exclusivement tourné vers l’inférence
La D-Series repose sur l’architecture Xe3P et intègre 32 cœurs. Intel annonce une bande passante mémoire de 1,5 To/s ainsi qu’une puissance de calcul atteignant 1,3 PFLOPS en FP8.
Cette carte PCIe 5.0 x16 de 350 W utilise un refroidissement à air. Elle ne possède ni sortie vidéo ni matériel dédié au rendu 3D, ce qui l’écarte du marché gaming ; de précédentes fuites indiquaient déjà que Xe3P ne donnerait naissance à aucune carte Arc destinée aux joueurs.
Les premiers exemplaires sont actuellement évalués par les clients, mais Intel n’a communiqué ni prix ni calendrier de disponibilité. Une déclinaison de 512 Go nécessiterait vraisemblablement un PCB différent ou un mélange de puces de capacités distinctes, sans qu’un partenaire ait pour l’instant été identifié.
Une telle capacité entraînerait aussi un coût particulièrement élevé. Elle renforcerait toutefois le positionnement de la D-Series sur l’inférence de grands modèles, où conserver davantage de poids et de cache en mémoire locale peut réduire la dépendance aux configurations multi-accélérateurs.
Source : Haze on X

