

Le géant des GPU IA pourrait confier une partie stratégique de leur assemblage à l’un des principaux rivaux industriels de TSMC. Une telle décision offrirait à Intel Foundry une référence majeure, tout en desserrant l’étau sur les capacités de packaging avancé.
Intel Foveros entrerait dans la chaîne de production de NVIDIA
L’analyste Jeff Pu, de la société sud-coréenne GF Securities, estime que NVIDIA pourrait recourir à la technologie de packaging Foveros au second semestre 2028. L’information reste à considérer avec prudence : aucun contrat ni produit précis n’est annoncé.
Cette hypothèse rejoint une première indiscrétion publiée en janvier par DigiTimes. Celle-ci évoquait l’utilisation potentielle des procédés Intel 18A ou 14A pour des composants associés aux futurs GPU Feynman, dont la production principale resterait confiée aux procédés avancés de TSMC.
Intel interviendrait donc plutôt sur des blocs de propriété intellectuelle non centraux ou sur les opérations réalisées après la fabrication des dies. Le 14A doit entrer en production à grande échelle au second semestre 2028, une échéance qui correspond au calendrier avancé par Jeff Pu.
Le packaging avancé devient un enjeu aussi critique que la gravure
La fabrication d’un accélérateur IA se partage entre le front-end, qui couvre notamment la réalisation des circuits sur wafer, et le back-end. Ce dernier regroupe la découpe, l’interconnexion et l’intégration des différents dies dans un boîtier exploitable au sein d’un centre de données.
Intel tente encore de s’imposer face à TSMC dans la production sous contrat aux nœuds les plus avancés. Le groupe dispose toutefois d’une offre plus établie dans le packaging avec EMIB, EMIB-T et Foveros. Google aurait déjà manifesté son intérêt pour EMIB-T afin d’intégrer ses TPU dédiés à l’IA.
Foveros mise sur un véritable empilement 3D
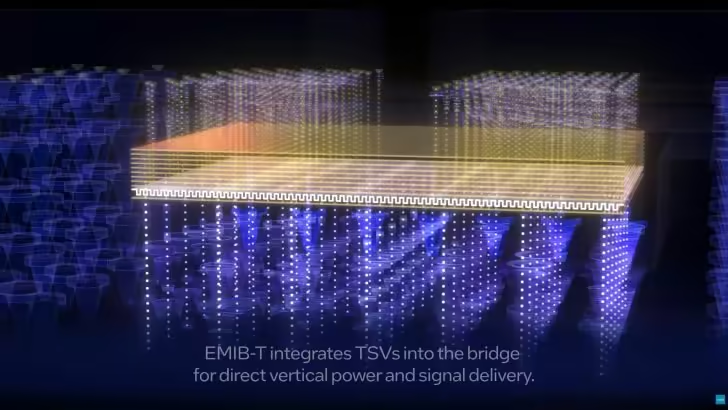
EMIB relie horizontalement plusieurs chiplets au moyen de ponts de silicium intégrés au substrat. EMIB-T complète cette architecture avec des TSV, des connexions verticales traversant le silicium pour acheminer directement alimentation et signaux.
Foveros va plus loin en empilant activement des tuiles de calcul ou d’autres chiplets sur un die de base. Cette organisation réduit l’emprise horizontale du boîtier et raccourcit les interconnexions, avec des gains potentiels en débit et en efficacité énergétique.
Pour NVIDIA, diversifier le back-end limiterait sa dépendance aux capacités de packaging de TSMC, fortement sollicitées par la demande mondiale en accélérateurs IA. Pour Intel, décrocher un programme lié à Feynman compterait probablement davantage comme validation industrielle de Foveros que comme victoire immédiate dans la gravure avancée.
Source : Wccftech

