

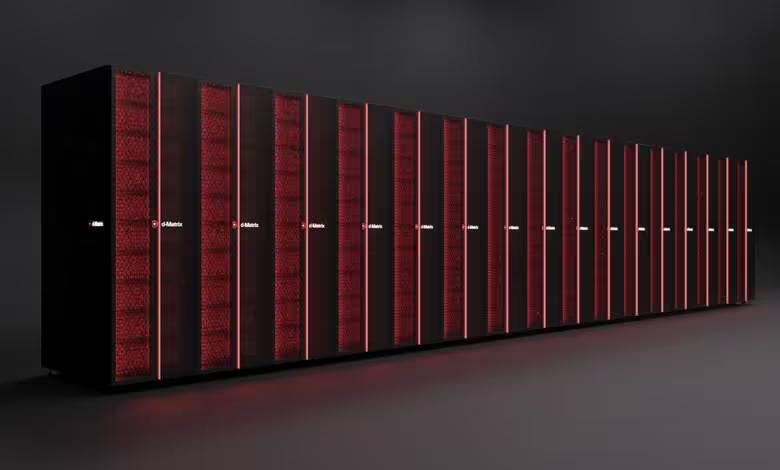
Jusqu’à 1 024 XPU Corsair peuvent désormais fonctionner au sein d’un même cluster refroidi par air. d-Matrix entend ainsi porter son architecture centrée sur la mémoire à l’échelle du mégawatt, sans imposer la reconstruction des centres de données existants.
d-Matrix Squadron passe à l’échelle du centre de données
Développé avec Arista, Broadcom et Supermicro, Squadron désigne une gamme de systèmes multiracks consacrés à l’inférence IA. d-Matrix exploite déjà cette infrastructure dans son centre de données d’Arizona pour ses travaux internes de recherche et développement, tandis que les premières unités sont expédiées à des clients prioritaires.
Le système vise notamment les laboratoires d’IA, les entreprises et les organisations souveraines exécutant des applications sensibles à la latence : génération de code, agents personnels, cybersécurité ou trading haute fréquence. Sid Sheth, fondateur et CEO de d-Matrix, a présenté Squadron lors de son discours d’ouverture à l’OCP Global Summit, au San Jose Convention Center.
L’annonce marque aussi l’évolution de d-Matrix, qui ne se présente plus seulement comme un concepteur de puces, mais comme un fournisseur d’infrastructures de calcul complètes. Les serveurs Corsair et les systèmes SquadRack sont désormais disponibles commercialement.
De huit serveurs à 16 racks et 1 024 XPU
Un SquadRack réunit huit serveurs d-Matrix. Squadron peut agréger jusqu’à 16 SquadRacks dans un cluster intégré, pour un maximum de 1 024 XPU Corsair. L’interconnexion repose sur les cartes réseau JetStream, tandis que la couche logicielle Aviator prend en charge le déploiement.
Les serveurs Corsair et les SquadRacks associent les XPU Corsair, les NIC JetStream et Aviator dans une architecture commune. Un client peut ainsi installer un serveur isolé, un rack complet ou plusieurs racks sans changer de plateforme.
L’ensemble utilise des standards industriels et un refroidissement par air. d-Matrix mise sur cette compatibilité pour permettre une intégration directe aux centres de données existants, sans refroidissement liquide ni chantier d’infrastructure coûteux et long.
Supermicro intervient sur l’ingénierie, l’intégration et la fabrication via ses Data Center Building Block Solutions, ou DCBBS. Son CEO Charles Liang met en avant un délai de mise en service réduit, ainsi que la prise en charge de charges IA avancées et d’environnements de calcul hétérogènes.
L’AFD atteint 20 415 tokens par seconde
Squadron peut exécuter des modèles complets uniquement sur les XPU Corsair, mais d-Matrix prévoit aussi une utilisation conjointe avec des serveurs GPU. Cette approche de calcul désagrégé répartit les différentes étapes du modèle entre les deux catégories d’accélérateurs.
Une démonstration sur silicium disponible
Lors de l’OCP Global Summit, Sid Sheth a dévoilé une implémentation de l’Attention-FFN Disaggregation, ou AFD, associant un système Squadron à des serveurs GPU. Les blocs Experts/FFN étaient déportés vers les racks Corsair afin d’exploiter leur efficacité énergétique.
d-Matrix revendique 845 tokens par seconde et par utilisateur. Avec 64 utilisateurs simultanés, la configuration hétérogène a atteint un débit total de 20 415 tokens par seconde. L’entreprise affirme être la première à faire fonctionner l’AFD, jusqu’ici largement discutée sur le plan théorique, sur du silicium effectivement disponible.
La démonstration AFD doit être présentée sur le stand C82 de d-Matrix à l’OCP Global Summit, le mercredi 14 octobre à 11 h et 14 h, heure du Pacifique, puis le jeudi 15 octobre à 11 h. Les informations commerciales sont également accessibles auprès de d-Matrix.
L’intérêt de Squadron tient moins au seul nombre de XPU qu’à sa capacité à s’insérer dans une infrastructure classique et à travailler avec des GPU. Si les résultats AFD se confirment sur davantage de modèles et de charges réelles, ce découpage pourrait réduire la pression énergétique de l’inférence sans contraindre les opérateurs à remplacer intégralement leurs équipements.
Source : TechPowerUp

