

Les accélérateurs IA grossissent à un rythme qui commence à heurter les limites physiques du packaging avancé. Cette pression pousse déjà l’industrie vers des formats 2.5D plus vastes, avec un avantage net pour TSMC à court et moyen terme.
CoWoS-L s’impose dans la montée en taille des puces IA
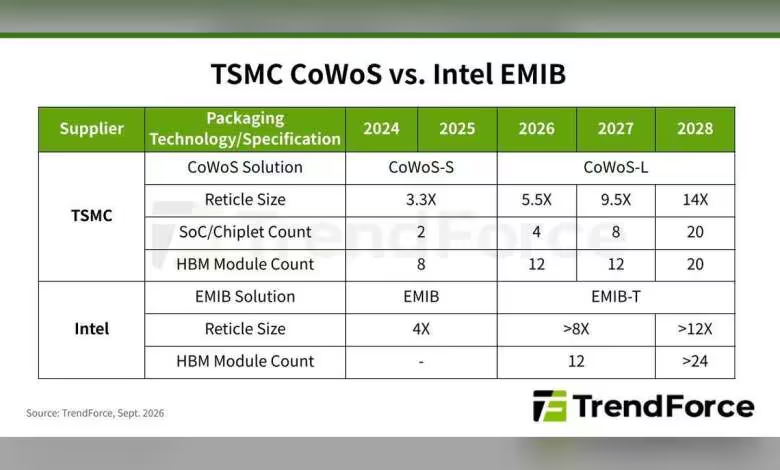
Les dernières projections de TrendForce montrent que les fournisseurs de GPU et les hyperscalers continuent d’augmenter la puissance et la polyvalence de leurs puces IA, ce qui fait de la taille du package un enjeu central pour le packaging 2.5D. Dans ce contexte, CoWoS-L est attendu comme la solution dominante pour les puces IA jusqu’en 2028, malgré la concurrence d’Intel EMIB-T.
La demande soutenue en IA continue notamment d’alimenter la stratégie de NVIDIA autour de solutions rack-scale intégrées de type GB/VR, qui embarquent un grand nombre de puces. Les expéditions de GPU haut de gamme de NVIDIA devraient progresser d’environ 30 % en glissement annuel en 2026. AMD doit de son côté accélérer sur le second semestre 2026 avec les séries MI400 et MI450, ce qui devrait encore soutenir les volumes globaux.
Chez les ASIC conçus par les CSP, Google est attendu en tête à la fois en volume et en dynamique de croissance en 2026, avec le TPU v7 comme produit principal. AWS monte également en puissance, avec une transition progressive de ses puces et de ses systèmes de serveurs IA vers Trainium v3 à partir du second semestre 2026. Microsoft et Meta restent pour l’instant davantage dépendants des serveurs GPU, avec des plans de déploiement ASIC plus limités.
TSMC sous tension, Intel tente une percée avec EMIB-T
Jusqu’ici, les puces de serveurs IA reposaient majoritairement sur le packaging CoWoS-S de TSMC, qui utilise un interposeur en silicium pour relier la HBM aux dies de calcul. Cette approche fournit les performances requises pour l’IA générative, mais elle commence à toucher ses limites à mesure que les dies grossissent et que le nombre de piles HBM augmente.
TrendForce souligne que CoWoS-S peut intégrer deux SoC ou chiplets et huit modules HBM, et qu’il devrait rester utilisé sur certains ASIC, comme le Maia 200 de Microsoft. En revanche, les conceptions qui exigent davantage de SoC, de chiplets et de modules HBM devront basculer vers CoWoS-L, qui permet des expositions de taille supérieure au réticule et intègre des ponts en silicium rapides dans l’interposeur pour améliorer l’interconnexion entre dies de calcul et HBM.
Adoption déjà engagée chez NVIDIA, AMD et plusieurs hyperscalers
Les accélérateurs IA de NVIDIA et d’AMD ont déjà adopté CoWoS-L. Côté ASIC IA, le MTIA 400 de Meta l’utilise déjà lui aussi, tandis qu’AWS et Microsoft devraient passer à CoWoS-L en 2027.
Le problème est que CoWoS-L exige un interposeur plus grand, donc plus coûteux, au moment même où les capacités de packaging de TSMC restent contraintes. Cette tension ouvre une fenêtre à Intel et à sa technologie EMIB, qui réduit la dépendance aux grands interposeurs et peut abaisser le coût global de packaging, même si les performances restent liées à la densité de routage du substrat.
Intel a fait évoluer ses spécifications line/space et microbump pour répondre à cette limite, tout en préparant des variantes plus avancées comme EMIB-T. Grâce à l’ajout de through-silicon vias, ou TSV, EMIB-T réduit les chemins de signal et améliore les performances globales du module.
Google devrait adopter EMIB-T en 2027, tandis qu’AWS teste également EMIB. Malgré cette concurrence directe, l’avance de CoWoS-L en maturité technologique et en rendement devrait suffire à maintenir TSMC au centre du packaging avancé pour les puces IA jusqu’en 2028. Ce point est stratégique, car le véritable goulet d’étranglement ne se situe plus seulement sur la gravure ou la HBM, mais aussi sur l’assemblage de ces très grands modules, devenu un facteur décisif de cadence industrielle.
Source : TrendForce

