

Les nouveaux racks destinés aux modèles de raisonnement tournent déjà dans les datacenters du géant de Redmond. Mais cette montée en puissance s’accompagne d’un autre chantier : permettre aux entreprises d’exécuter davantage de traitements près de leurs données, jusque sur leurs postes de travail.
Vera Rubin en préversion dans Azure
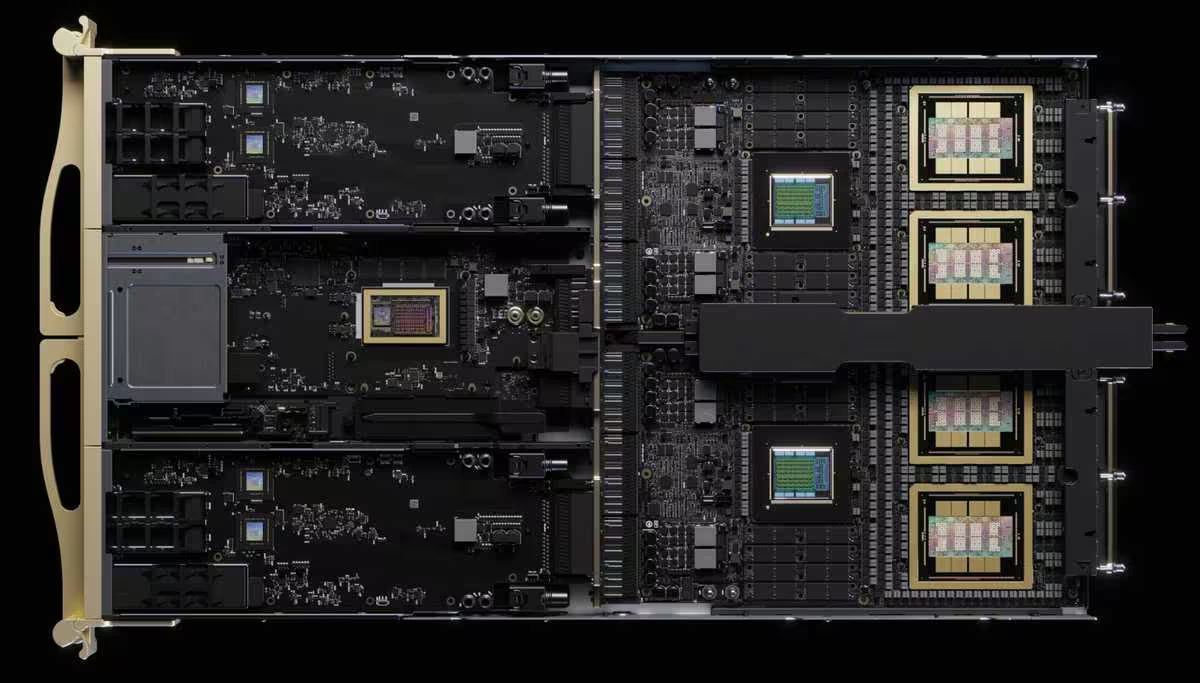
Microsoft exploite des systèmes NVIDIA Vera Rubin NVL72 dans Azure pour les applications agentiques, le raisonnement exigeant ainsi que l’entraînement et l’inférence de modèles à grande échelle. Ce déploiement reste présenté comme une préversion, et non comme une disponibilité générale du service.
Les deux partenaires travaillent aussi à étendre l’informatique confidentielle aux infrastructures d’IA bare metal et à l’échelle du rack. L’objectif est de protéger les modèles et les données pendant leur traitement, notamment pour les entreprises manipulant des informations propriétaires ou réglementées. Un autre volet porte sur NVIDIA MaxLPS, afin d’obtenir davantage de performances dans l’enveloppe électrique disponible des datacenters.
Les résultats MLPerf cités pour illustrer cette collaboration concernent toutefois Blackwell, pas Rubin. Dans MLPerf Training v6.1, Azure a mobilisé 10 240 GPU NVIDIA au sein de systèmes GB200 NVL72 sur DeepSeek-V3, soit le plus grand déploiement de cette session. Dans MLPerf Inference v6.1, ses GB300 NVL72 ont devancé de plus de 10 % les autres soumissions cloud en débit interactif sur DeepSeek-R1, d’après Signal65.
Nemotron se spécialise dans Foundry et gagne les infrastructures locales
La collaboration porte également sur les modèles ouverts proposés dans Microsoft Foundry. La gamme Nemotron 3.5 s’étend sur Foundry Managed Compute : Super vise les agents exécutant des tâches longues de développement, de recherche ou de gestion, tandis que Lightning privilégie les réponses rapides et l’utilisation d’outils.
EY a utilisé Programmed Training dans Microsoft Foundry pour adapter des modèles NVIDIA Nemotron à la classification de relevés d’achats d’entreprise. Sur son jeu d’évaluation, le cabinet rapporte une amélioration de la précision de 55 % et un coût divisé par 15 face à des modèles propriétaires de pointe. Ces gains concernent donc une tâche spécialisée et ce jeu de données, pas une comparaison générale entre modèles.
La prise en charge élargie de Nemotron 3.5 dans Foundry Local apporte aux environnements Azure Local des fonctions de raisonnement, de génération de code et d’agents utilisant des outils. Des modèles de recherche d’information doivent aussi permettre de retrouver des éléments dans les textes, les images de documents, les graphiques et les tableaux.
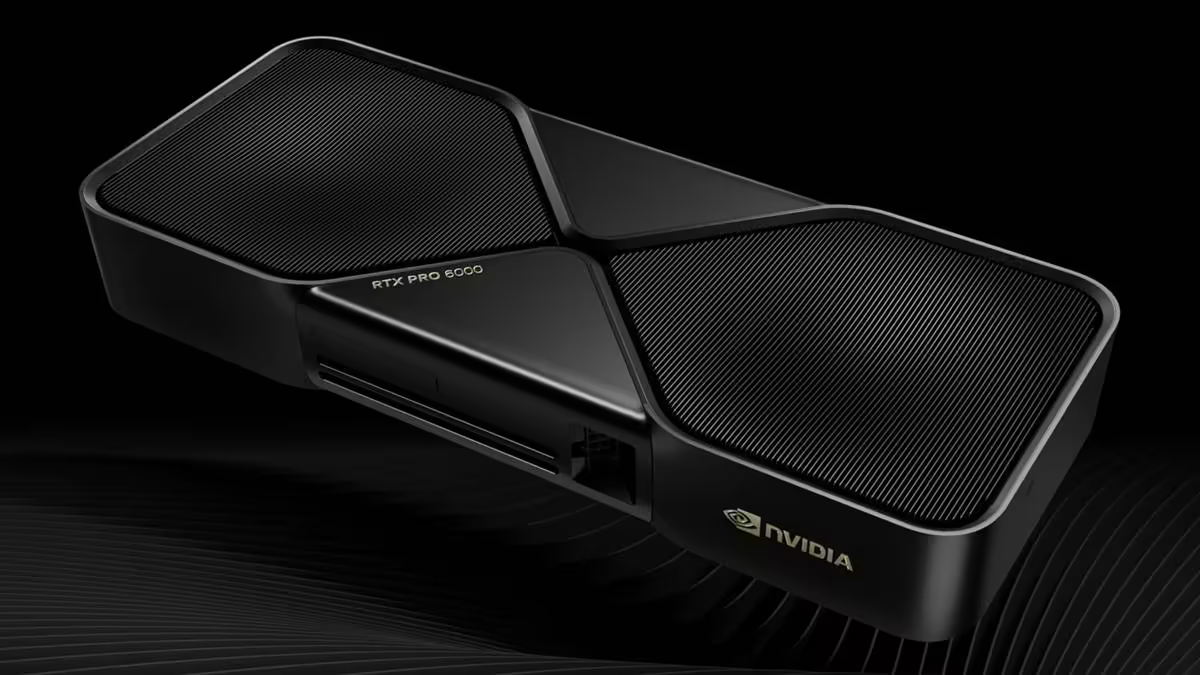
Côté matériel, Azure Local prendra en charge les RTX PRO 6000 Blackwell proposées par les partenaires constructeurs. La plateforme s’étend également aux modules NVIDIA Jetson Thor et Jetson Orin pour la vision industrielle, la robotique et les opérations autonomes. Les modèles d’IA physique de NVIDIA, dont Cosmos, rejoignent eux aussi Foundry Local.
RTX Spark sur le bureau, double flux 4K dans Windows 365
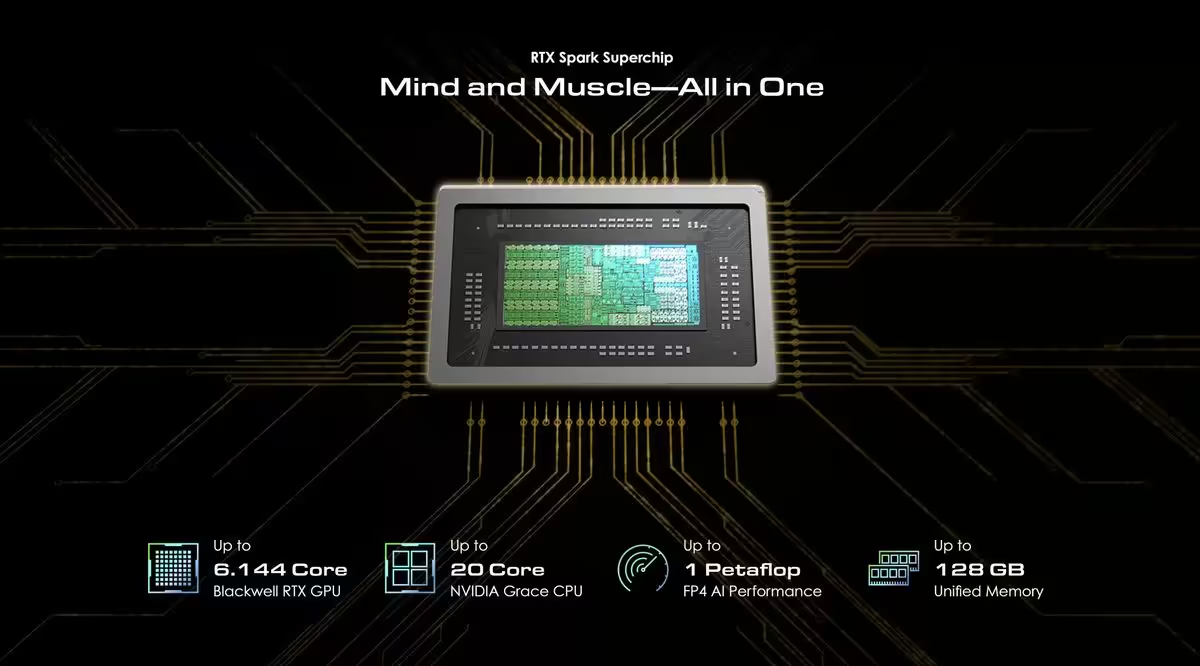
Sur les PC Windows équipés de NVIDIA RTX Spark, les deux groupes présenteront à Ignite des applications de grands modèles de langage exécutées directement sur la machine. Le visuel du RTX Spark Superchip indique un GPU Blackwell RTX à 6 144 cœurs, un CPU NVIDIA Grace à 20 cœurs, 128 Go de mémoire unifiée et une puissance IA annoncée de 1 pétaflop en FP4.
Pour les postes hébergés, NVIDIA et Microsoft apportent Direct Stream aux Windows 365 Cloud PC accélérés par GPU. Le dispositif doit prendre en charge jusqu’à deux flux 4K à 60 images par seconde, avec une faible latence annoncée même sur des réseaux difficiles. Les inscriptions à une préversion limitée sont ouvertes ; la préversion publique est prévue pour début 2027.
L’enjeu dépasse donc le renouvellement des accélérateurs du cloud. En étendant les mêmes familles de modèles aux infrastructures locales et aux PC, Microsoft et NVIDIA cherchent à conserver les entreprises dans leur environnement logiciel, même lorsque les contraintes de confidentialité ou de latence imposent de déplacer les traitements hors des datacenters Azure.
Source : Wccftech

