

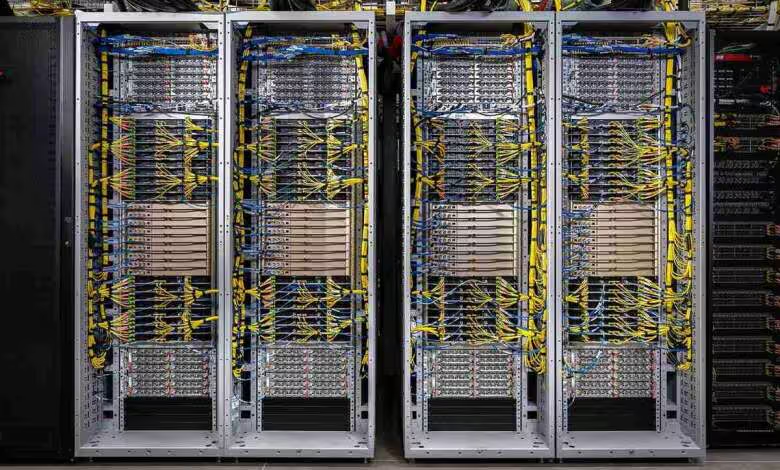
Les objectifs architecturaux affichés au GTC 2026 ont cédé la place aux performances réellement soutenues en usine. Les débits reculent sur le papier, mais NVIDIA affirme que les résultats indépendants déjà publiés reposaient sur ce matériel final.
NVIDIA Vera Rubin passe aux chiffres de production
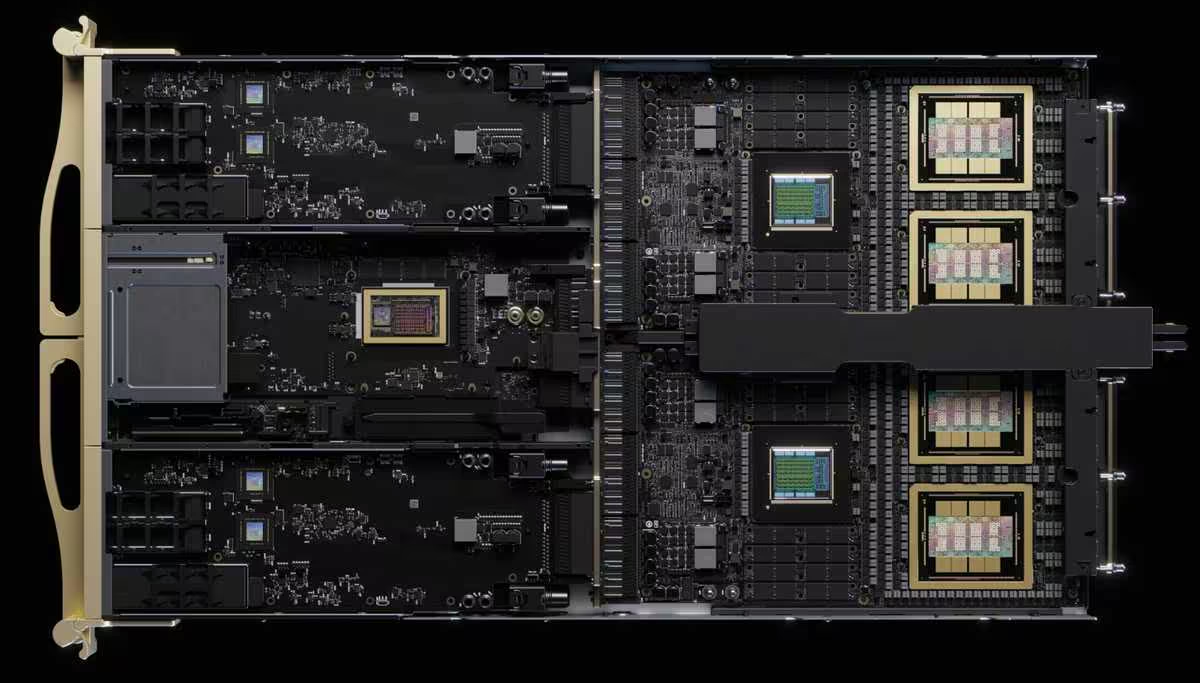
Lors de la présentation initiale, chaque GPU Rubin était crédité de 288 Go de HBM4 à 22 To/s, avec une liaison NVLink 6 atteignant 3,6 To/s. La fiche technique définitive conserve la capacité mémoire, mais ramène ces débits à 19,2 To/s pour la HBM4 et 3 To/s pour NVLink 6, soit des baisses respectives de 12,7 % et 16,7 %.
NVIDIA explique que les valeurs communiquées pendant le développement constituaient des objectifs préliminaires. Les données désormais publiées sur son site et dans la fiche Vera Rubin correspondent à ce que les systèmes soutiennent après qualification et en production de volume.
Ces révisions concernent toutes les configurations. Le Vera Rubin Superchip passe de 44 à 38,5 To/s en HBM4, soit 12,5 % de moins, et de 7,2 à 6 To/s pour NVLink, soit 16,7 % de moins. Sa bande passante réseau progresse en revanche de 0,8 à 0,9 To/s, une hausse de 12,5 %.
NVL72 et NVL8 également révisés
Le rack Vera Rubin NVL72 conserve 20,7 To de HBM4. Sa bande passante mémoire descend toutefois de 1 580 à 1 400 To/s, soit 11,4 %, tandis que NVLink recule de 260 à 216 To/s, soit 16,9 %. La partie réseau augmente de 28,8 à 32,4 To/s, là encore de 12,5 %.
Les écarts sont plus marqués sur le système HGX Rubin NVL8. La capacité HBM4 passe de 2,3 à 2 To, soit 13 % de moins, et son débit chute de 176 à 130 To/s, une réduction de 26,1 %. La bande passante des commutateurs NVLink recule de 28,8 à 24 To/s, soit 16,7 %, tandis que le réseau progresse de 1,6 à 1,8 To/s, soit 12,5 %.
La puissance d’entraînement annoncée pour cette configuration évolue aussi. Elle passe de 280 à 270 PFLOPS en NVFP4, soit 3,6 % de moins, et de 140 à 130 PFLOPS en FP8/FP6, soit une baisse de 7,1 %.
Les benchmarks utiliseraient déjà les spécifications finales
NVIDIA soutient qu’une caractéristique isolée ne suffit pas à déterminer les performances applicatives. Vera Rubin vise les agents IA, dont les tâches enchaînent raisonnement, appels d’outils, récupération de données et évaluations des milliers de fois. Le résultat dépendrait donc du co-design des modèles, des logiciels, du calcul, du réseau et de la mémoire à l’échelle du centre de données.
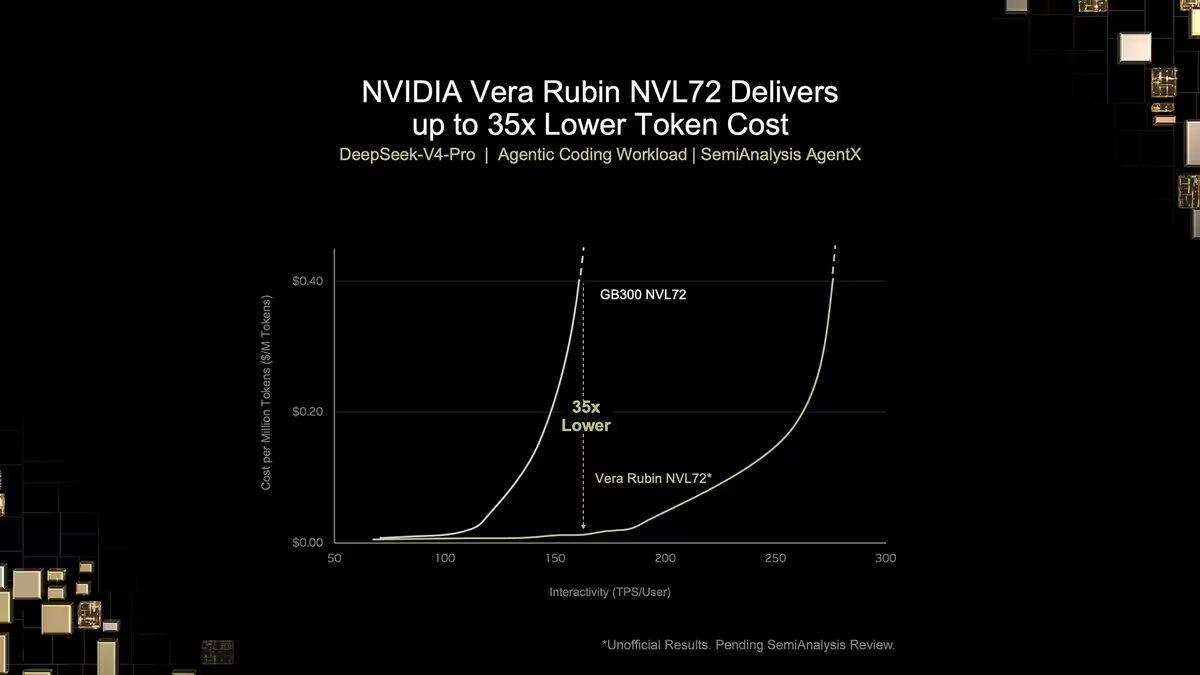
Le groupe précise que le Vera Rubin NVL72 est en pleine production et déjà expédié. Les benchmarks tiers disponibles depuis plusieurs mois auraient tous été exécutés avec les spécifications de production aujourd’hui publiées. NVIDIA renvoie notamment aux évaluations AgentX de SemiAnalysis et AgentPerf d’Artificial Analysis.
D’après l’entreprise, ces mesures montrent jusqu’à 30 fois plus de performances par watt et 30 fois plus de tokens par dollar face au GB300 NVL72 de génération précédente. Les corrections apportées aux fiches techniques ne modifieraient donc pas rétrospectivement les résultats accessibles au public.
Cette mise au point ne rend pas les réductions de débit anecdotiques, en particulier les 26,1 % perdus par le NVL8 en bande passante HBM4. Elle déplace néanmoins la comparaison vers les performances soutenues d’un rack complet. Pour les clients, les benchmarks reproductibles et le comportement sur leurs propres charges resteront plus significatifs que les objectifs de crête communiqués avant qualification.
Source : Wccftech

