

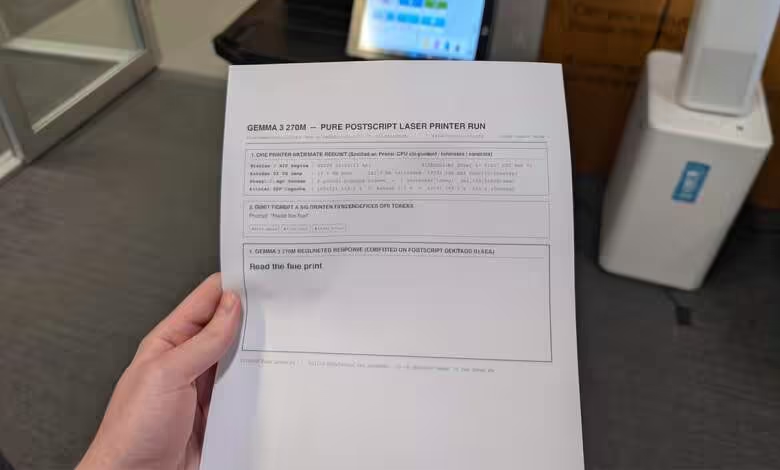
Le document envoyé au bureau contenait davantage qu’une page à reproduire : il faisait calculer la suite d’une phrase par le périphérique lui-même. Au bout du traitement, la réponse est sortie sur papier.
Omar Sanseviero, ingénieur chez Google DeepMind, a fait fonctionner le modèle Gemma 3 à 270 millions de paramètres sur une imprimante laser Ricoh. Il décrit sur X une expérience menée avec Carbon, sans modification du firmware ni ajout d’une carte de calcul externe.
Gemma 3 exécuté dans l’interpréteur PostScript
Le point d’entrée est PostScript, le langage de description de pages intégré à l’imprimante. Turing-complet, il permet ici d’exécuter autre chose que des instructions de mise en page. Carbon, un moteur léger d’inférence pour transformers, a été associé à une version quantifiée du modèle pour constituer un unique fichier d’impression PostScript brut.
L’exécution s’effectue nativement dans l’interpréteur PostScript Level 3, sur le CPU de la machine, et parcourt les 18 couches du transformer. Pour contenir l’occupation mémoire, le dispositif utilise un chargement dynamique des couches : celles-ci entrent et sortent de la mémoire au fil du calcul.
Le pic annoncé atteint ainsi 14,1 Mo, sur les 244,6 Mo de mémoire virtuelle alloués à PostScript. Les quelque 14 Mo mis en avant ne correspondent donc pas à toute la mémoire disponible sur le périphérique, mais à la consommation maximale relevée pendant cette exécution.
Une réponse imprimée après 184 secondes de traitement
La démonstration rapporte un débit de 61,3 tokens par seconde. Le relevé matériel photographié à côté de la Ricoh détaille aussi le traitement d’une entrée de quatre tokens, « Read the fine » : 184 secondes pour la phase de prefill, puis 0,1 seconde pour décoder un seul token généré, avec un total affiché de 184 secondes.
Une fois le calcul terminé dans la pile PostScript, l’appareil a imprimé « Read the fine print ». Le test porte donc sur une complétion très courte, avec une attente initiale importante, plutôt que sur une conversation prolongée.
L’exécution locale d’un LLM de 3 milliards de paramètres sur un Pixel 7 avait déjà illustré les possibilités de matériels grand public. Cette expérience explore une contrainte différente : faire tenir l’inférence dans un environnement logiciel destiné à l’impression. Son intérêt technique réside surtout dans le chargement des couches à la demande, qui réduit fortement la mémoire de travail, sans que ce seul essai permette de juger les performances sur des générations longues.
Source : Wccftech

