

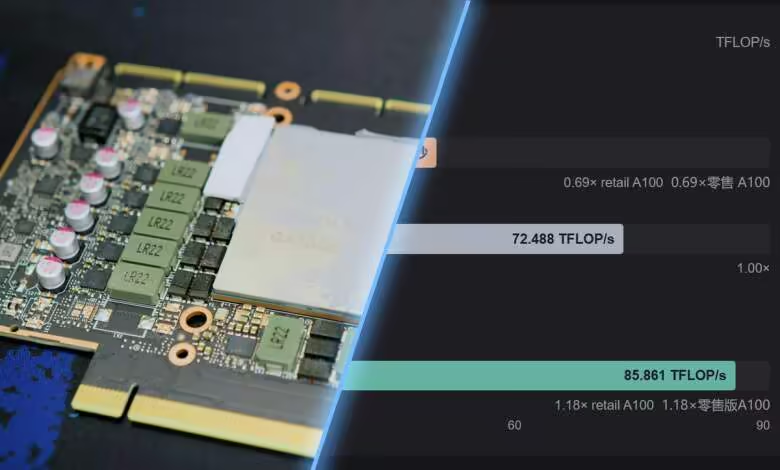
Une ancienne référence destinée aux mineurs cachait assez de mémoire pour multiplier par dix sa capacité accessible. En intervenant sur son alimentation, la chercheuse Kate a aussi réactivé suffisamment de ressources de calcul pour devancer un accélérateur professionnel dans une épreuve précise.
La CMP 170HX livre davantage de son GPU GA100
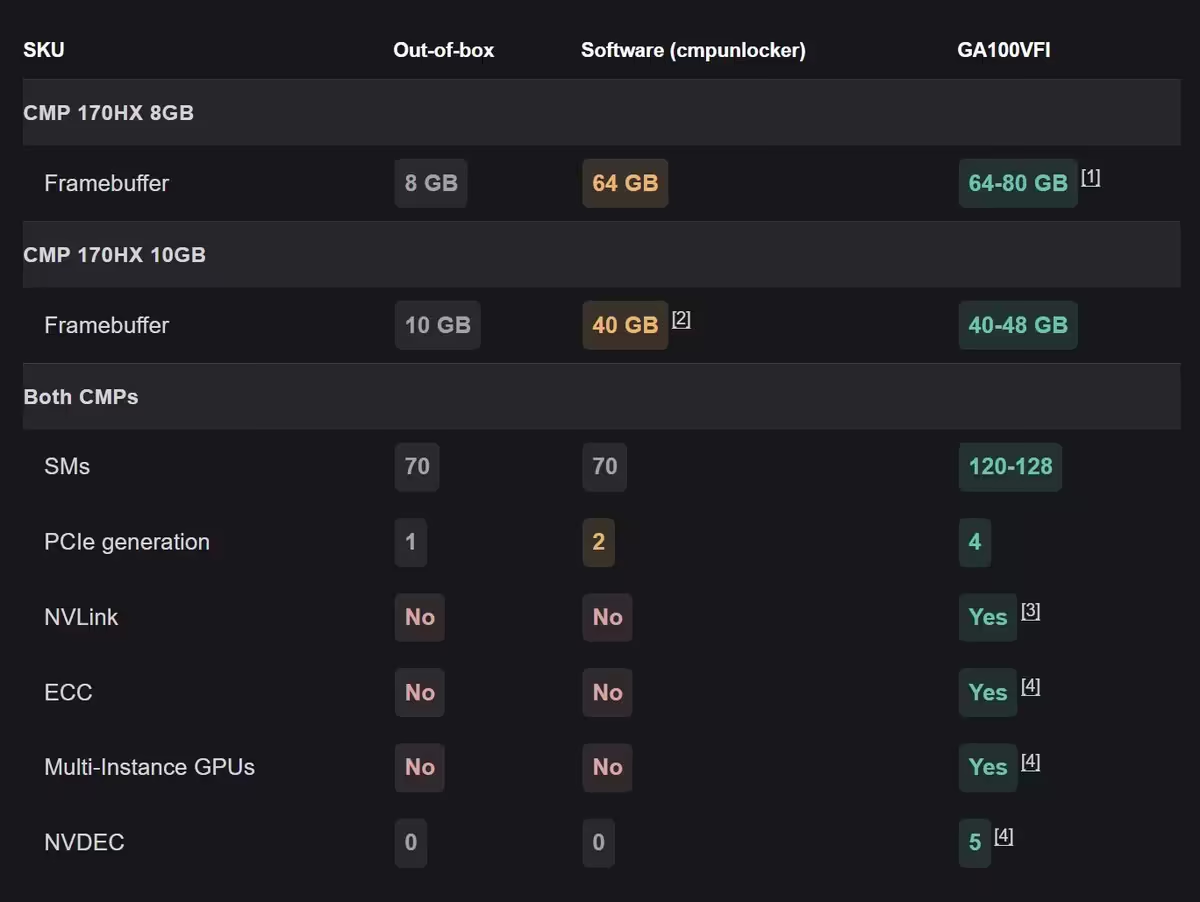
Les premiers déblocages logiciels avaient déjà changé la cote de cette carte NVIDIA. Quelques mois auparavant, CMPUnlocker avait révélé une partie de sa mémoire cachée, avec notamment des configurations passant de 8 à 64 Go et de 10 à 40 Go. L’outil, associé à des déblocages pouvant atteindre 80 Go, avait contribué à faire grimper les prix d’environ 100 dollars à plus de 1 000 dollars, soit approximativement 90 à plus de 900 euros à titre indicatif.
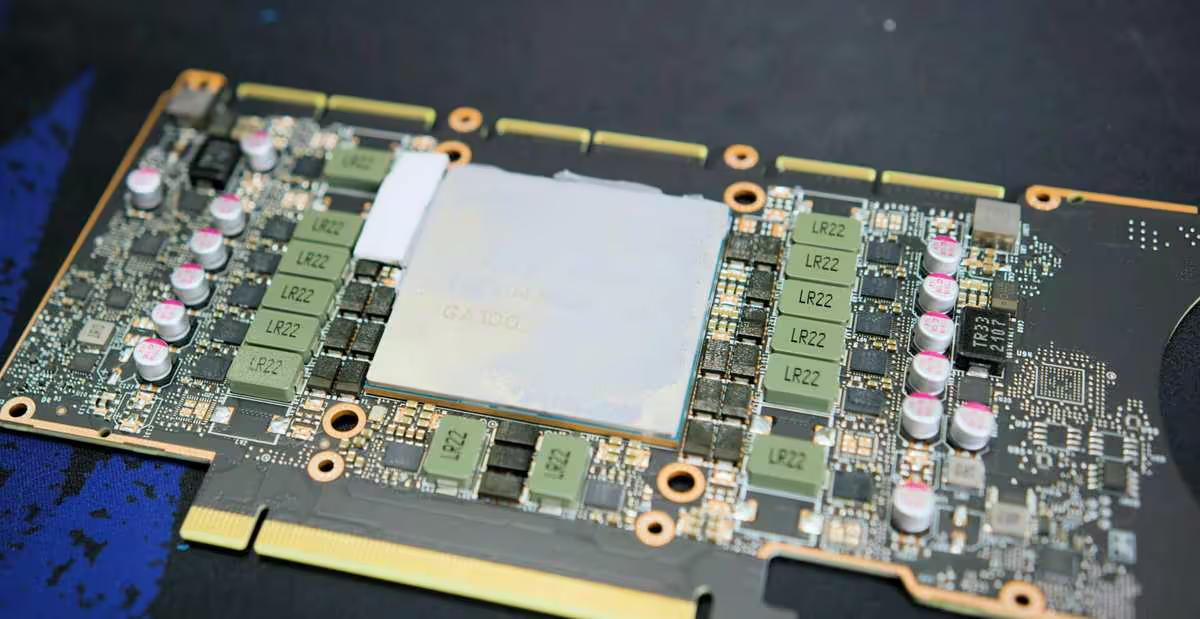
Les travaux de Kate vont plus loin qu’une modification logicielle. La chercheuse emploie une injection de faute par variation de tension sur le GA100 afin d’interférer avec la lecture des fusibles de configuration. Cette intervention permet, d’après les résultats rapportés, de réécrire des configurations normalement protégées et d’exposer des ressources désactivées en usine par NVIDIA.
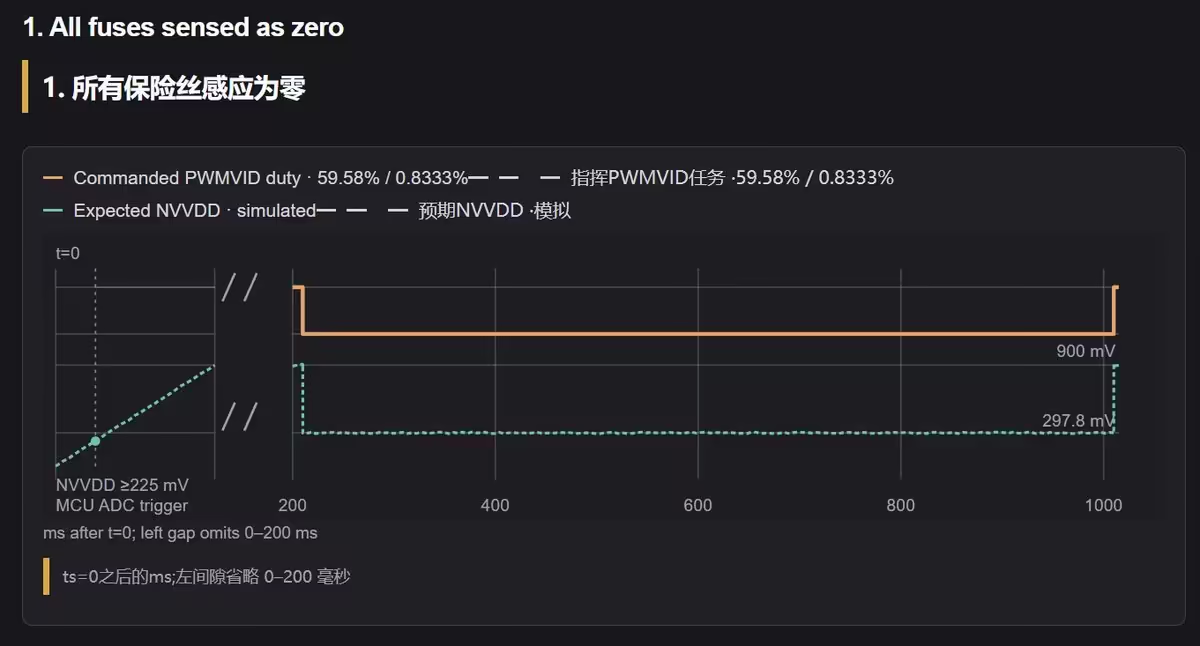
Un relevé présenté avec ces travaux illustre un état où tous les fusibles sont lus à zéro. Il indique une consigne PWMMVID de 59,58 %, avec une tension NVVDD attendue initialement à 900 mV, puis descendant vers 297,8 mV.
Sur les dix cartes de 8 Go testées par Kate, neuf ont rendu accessibles 80 Go de HBM physiquement présents. La dernière est restée à 64 Go, toute sa mémoire n’étant pas fonctionnelle. Les puces débloquées disposent par ailleurs d’environ 120 à 126 SM opérationnels.
85,9 TFLOPS, mais sur une seule épreuve OpenCL
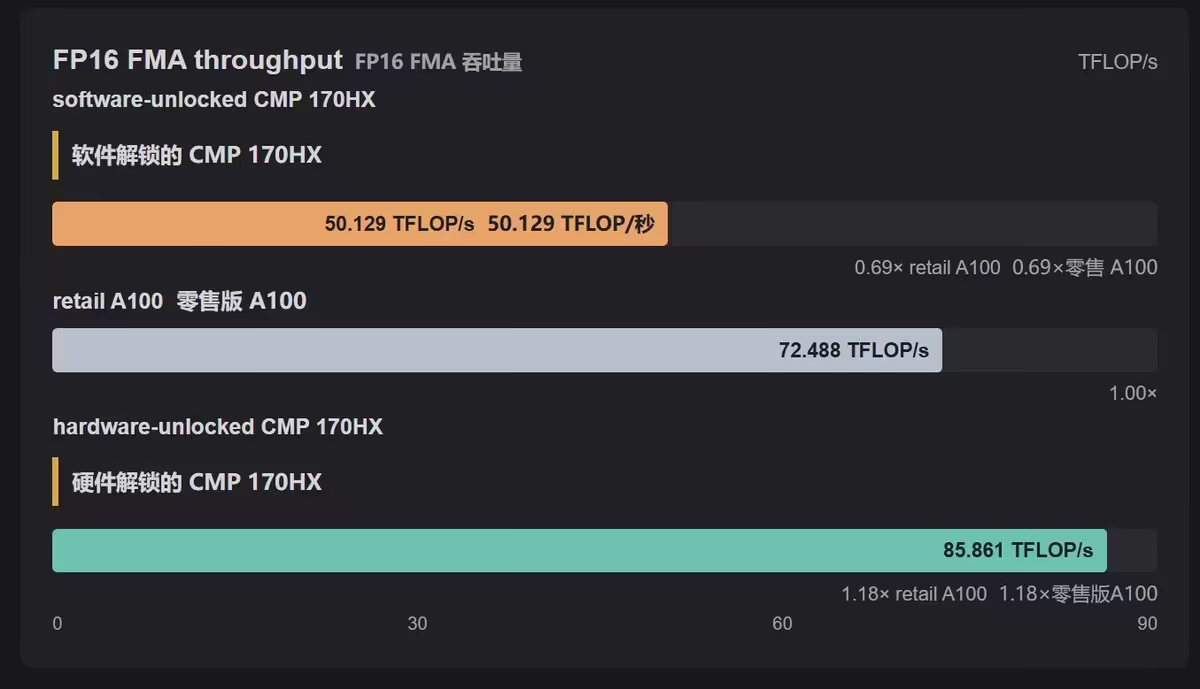
Le benchmark FP16 de ProjectPhysX, exécuté sous OpenCL, donne une mesure concrète du gain. Le graphique de débit FMA FP16 affiche 50,129 TFLOPS pour la carte déverrouillée par logiciel, 72,488 TFLOPS pour une A100 du commerce et 85,861 TFLOPS pour l’exemplaire modifié matériellement.
Arrondis, ces résultats placent donc la carte modifiée à 85,9 TFLOPS, contre 72,5 TFLOPS pour l’A100, soit environ 18 % d’avance. Le résultat porte toutefois sur ce test précis de calcul FP16 : il ne constitue pas une comparaison globale des deux cartes.
Plusieurs fonctions importantes de l’A100 restent à évaluer, notamment l’ECC, le partitionnement MIG et certaines fonctionnalités vidéo. Le fonctionnement du PCIe et de NVLink nécessite également des travaux supplémentaires. Ces limites comptent autant que le débit de calcul lorsqu’il s’agit d’envisager un remplacement dans une machine de production.
Cette expérience rejoint d’autres projets de déverrouillage de GPU NVIDIA, dont ceux visant à libérer davantage de calcul IA sur les GeForce RTX 30. Son intérêt tient ici à la combinaison d’une capacité mémoire considérablement accrue et de ressources de calcul réactivées. Mais avec des cartes déjà renchéries par les premiers outils logiciels, l’intérêt économique dépendra aussi de la reproductibilité de la modification et des fonctions effectivement utilisables, pas seulement du score obtenu.
Source : IT Home

