


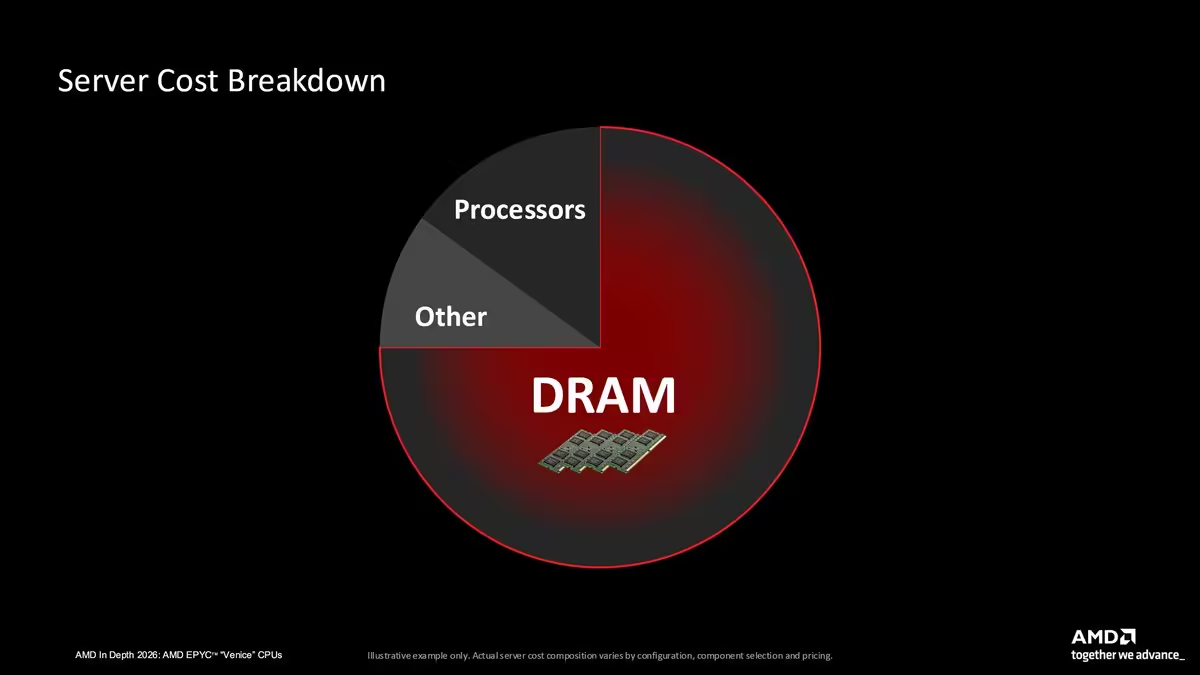
La mémoire vive peut désormais représenter 75 % du coût d’un serveur, alors qu’une grande partie de ses pages reste rarement sollicitée. Pour réduire cette dépense, le fabricant des processeurs EPYC propose de déplacer ces données vers les SSD, en anticipant leur retour en RAM grâce à l’IA.
AMD MEXT cible d’abord la mémoire sous-utilisée
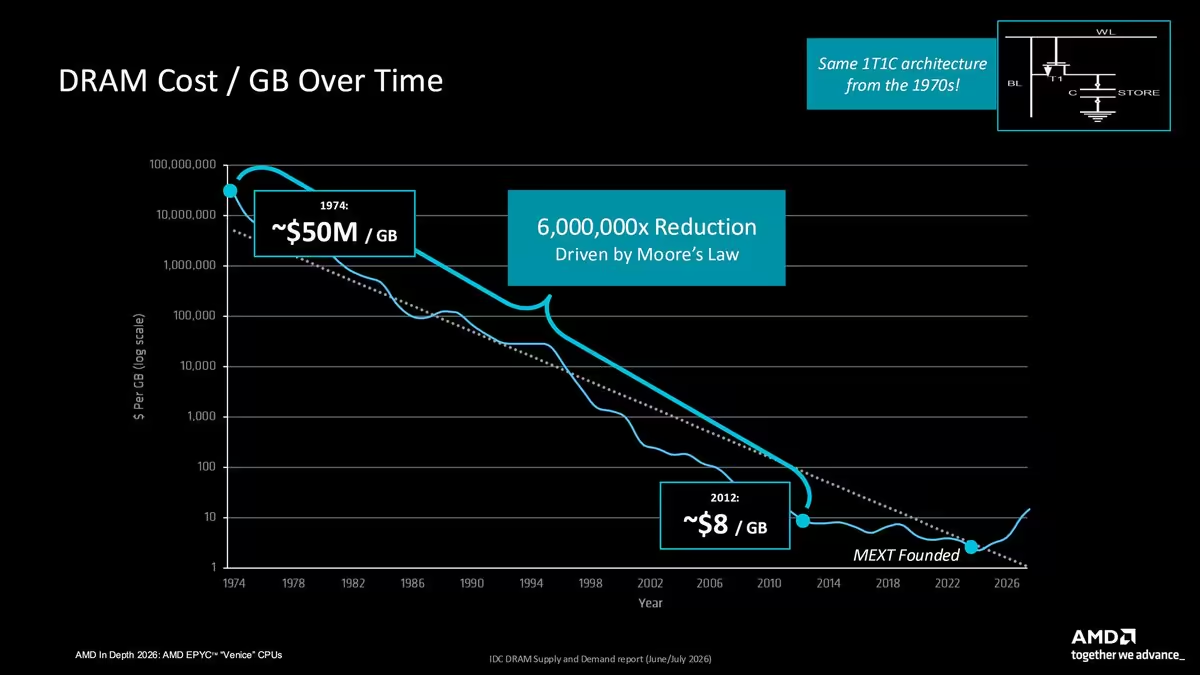
Le projet MEXT, lancé en 2022, répond à une double contrainte : la hausse des prix et les tensions d’approvisionnement en DRAM, absorbée en grande partie par l’IA et les centres de données. AMD rappelle que son coût est passé d’environ 50 millions de dollars par Go dans les années 1970, avec un point de référence en 1974, à environ 8 dollars en 2012, soit une division par 6 millions associée à la loi de Moore. Il dépasse désormais de nouveau les 10 dollars par Go.
À titre purement indicatif, avec une conversion arrondie de 1 dollar pour 0,92 euro, ces montants correspondent respectivement à 46 millions d’euros, 7,40 euros et plus de 9,20 euros par Go. Ces équivalences ne constituent pas des tarifs européens.
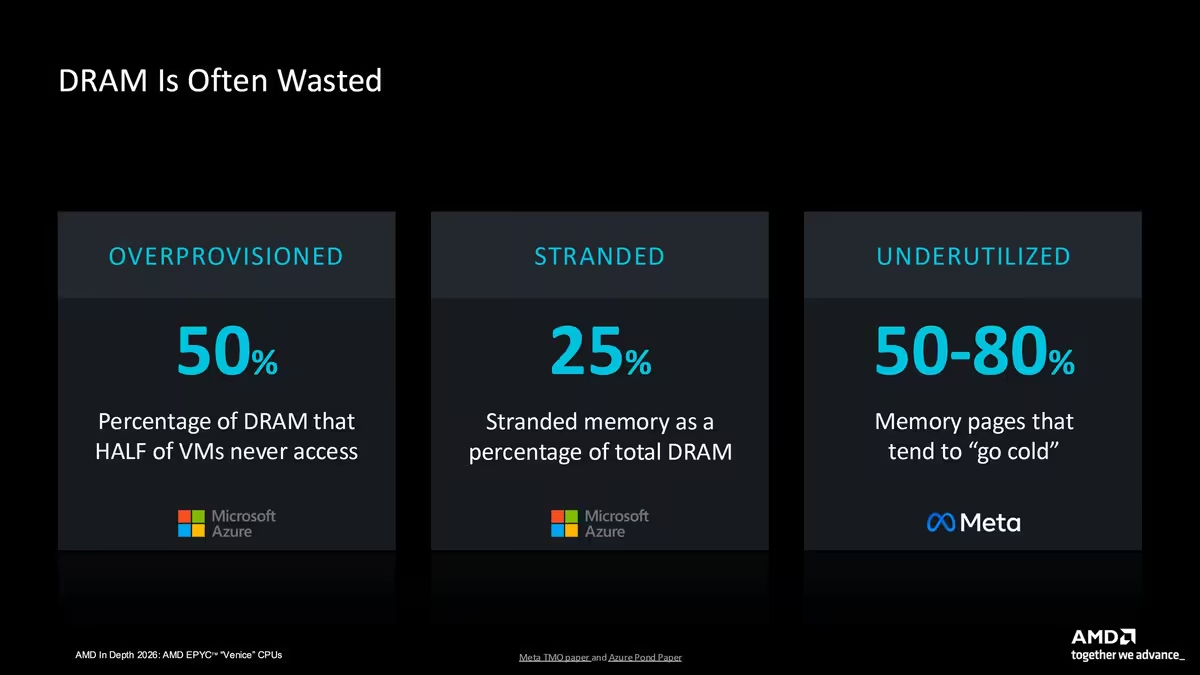
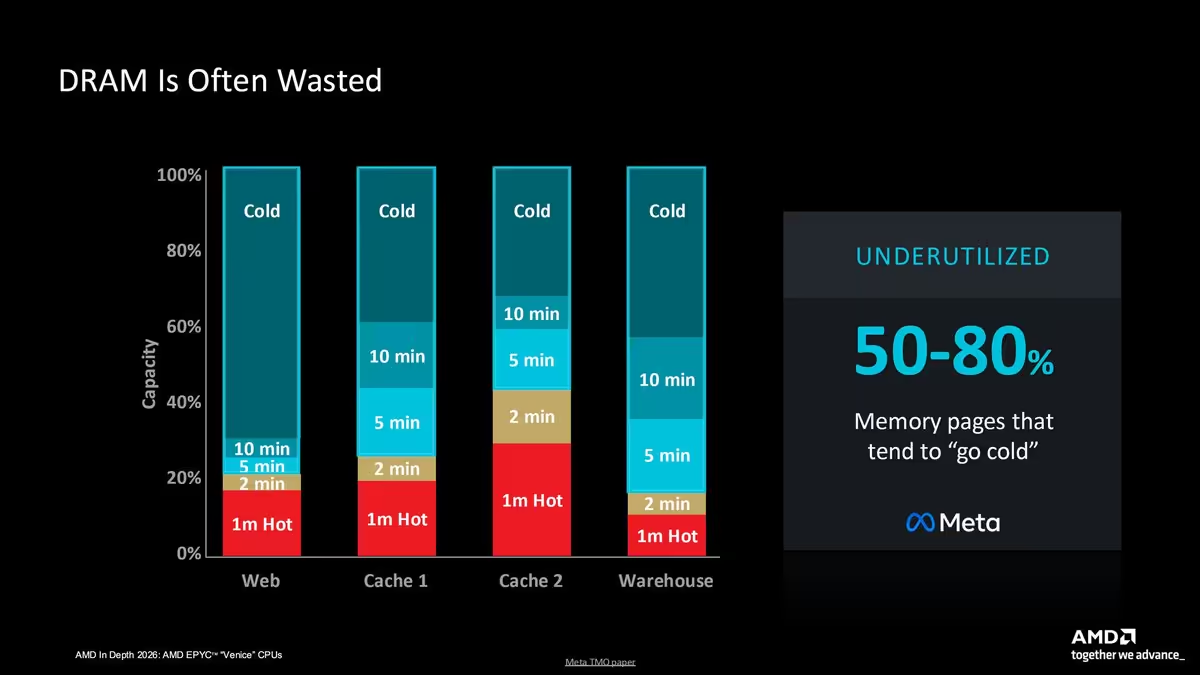
Le problème n’est toutefois pas seulement le prix du composant. À partir d’exemples de Microsoft Azure et de Meta, AMD évoque 50 % de surprovisionnement, avec une moitié de la mémoire jamais utilisée par la machine virtuelle, et 25 % de DRAM immobilisée dans les instances. Selon les charges, 50 à 80 % de la mémoire serait sous-utilisée, les pages devenant « froides » ; les exemples présentés couvrent le Web, deux caches et un entrepôt de données.
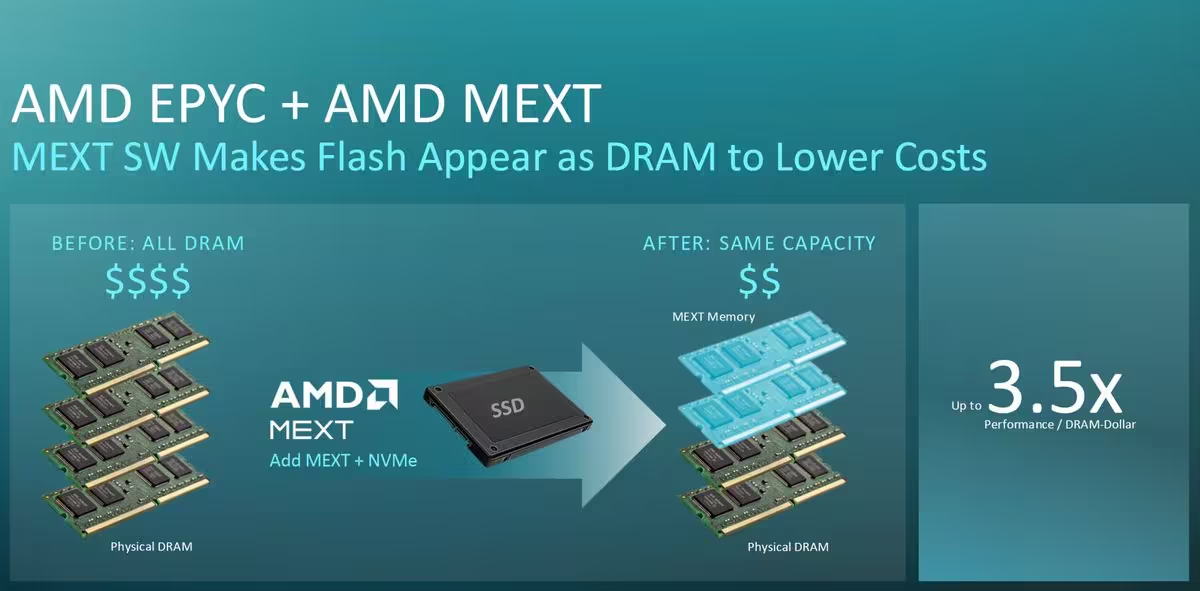
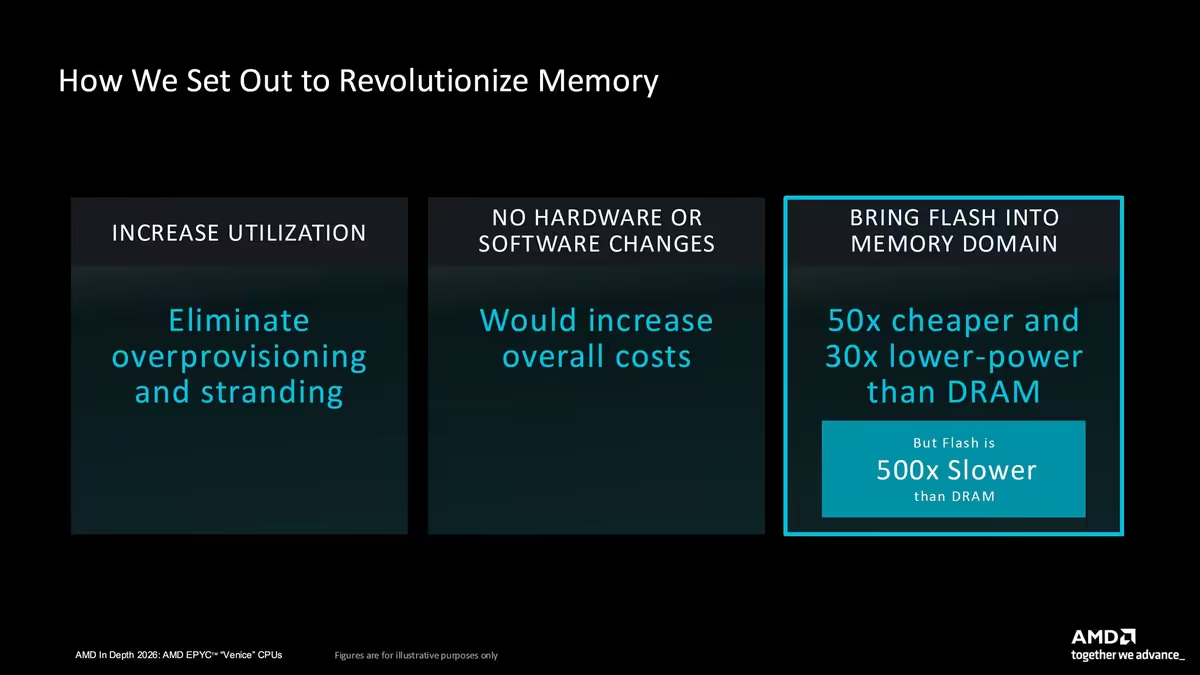
Ces proportions décrivent des phénomènes différents et ne s’additionnent pas. MEXT cherche à limiter le surprovisionnement et la mémoire immobilisée, tout en faisant entrer la Flash dans l’espace mémoire accessible aux applications, sans modification de celles-ci ni matériel spécifique.
Anticiper les accès plutôt qu’accélérer les SSD
La Flash conserve un handicap majeur : AMD la présente comme 500 fois plus lente que la DRAM, mais avec une consommation 30 fois inférieure. La diapositive du constructeur affiche aussi un coût 50 fois inférieur ; le texte de Wccftech évoque pour sa part une réduction de 50 % du coût d’acquisition.
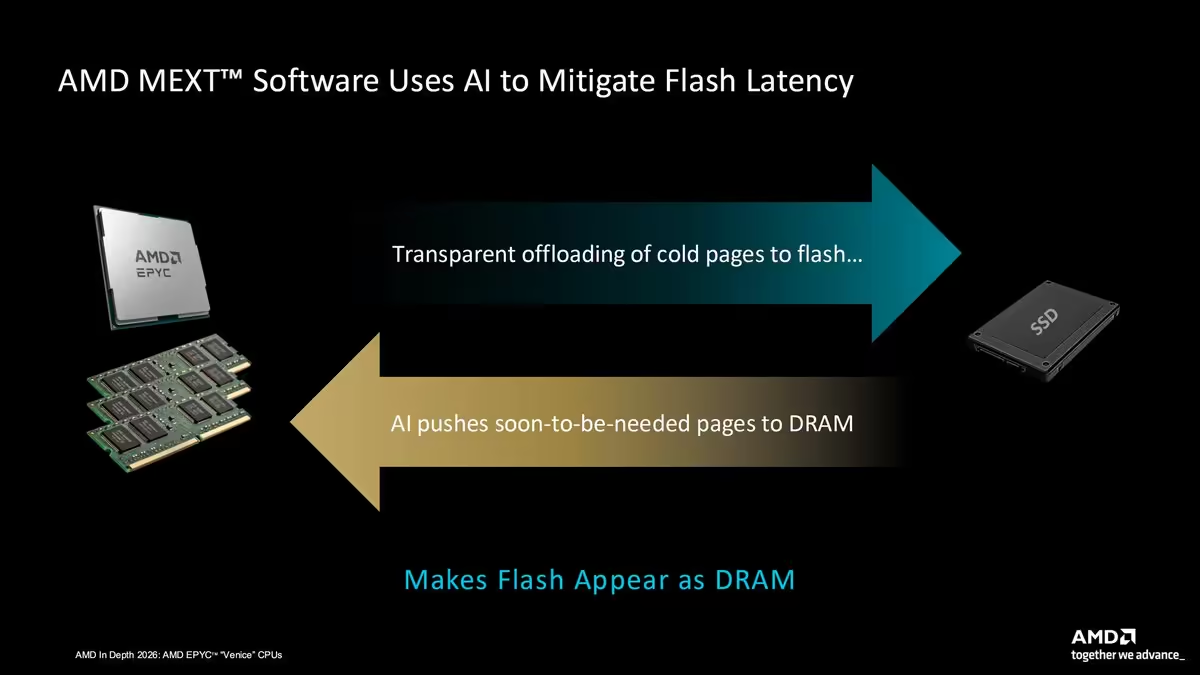
MEXT déporte les pages froides sur le stockage Flash et utilise des modèles prédictifs pour rapatrier en DRAM celles qui devraient bientôt servir. Le logiciel ne change donc pas la latence intrinsèque du support : il cherche à éviter que l’application attende un accès au SSD.
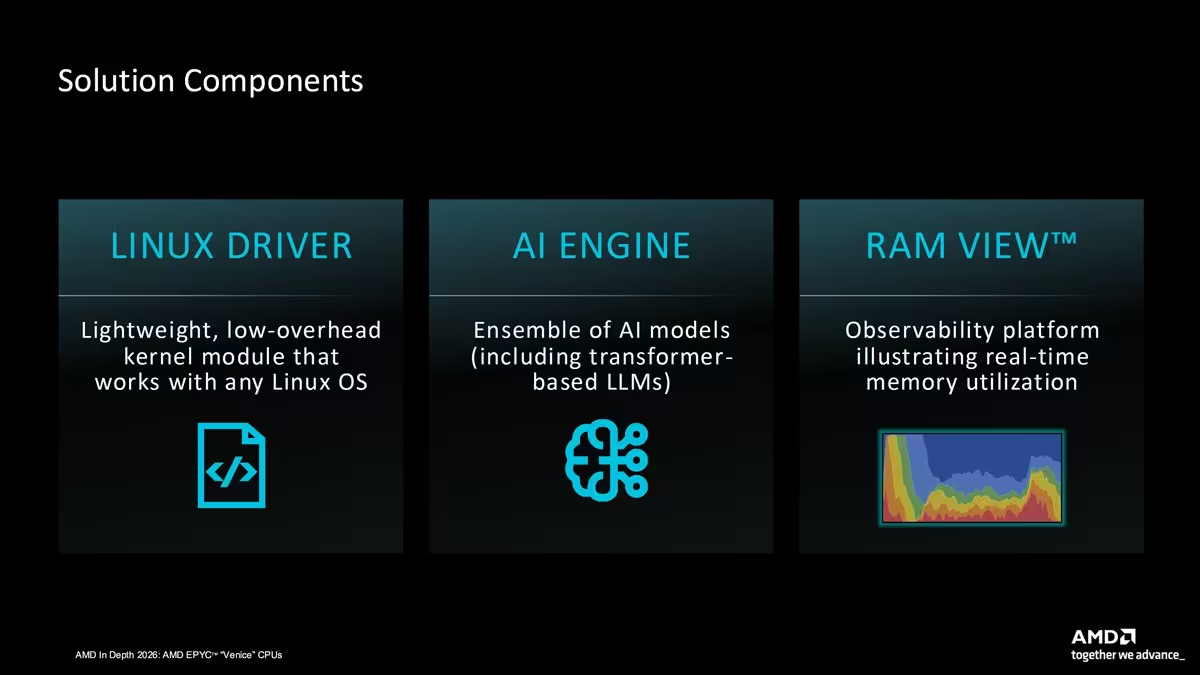
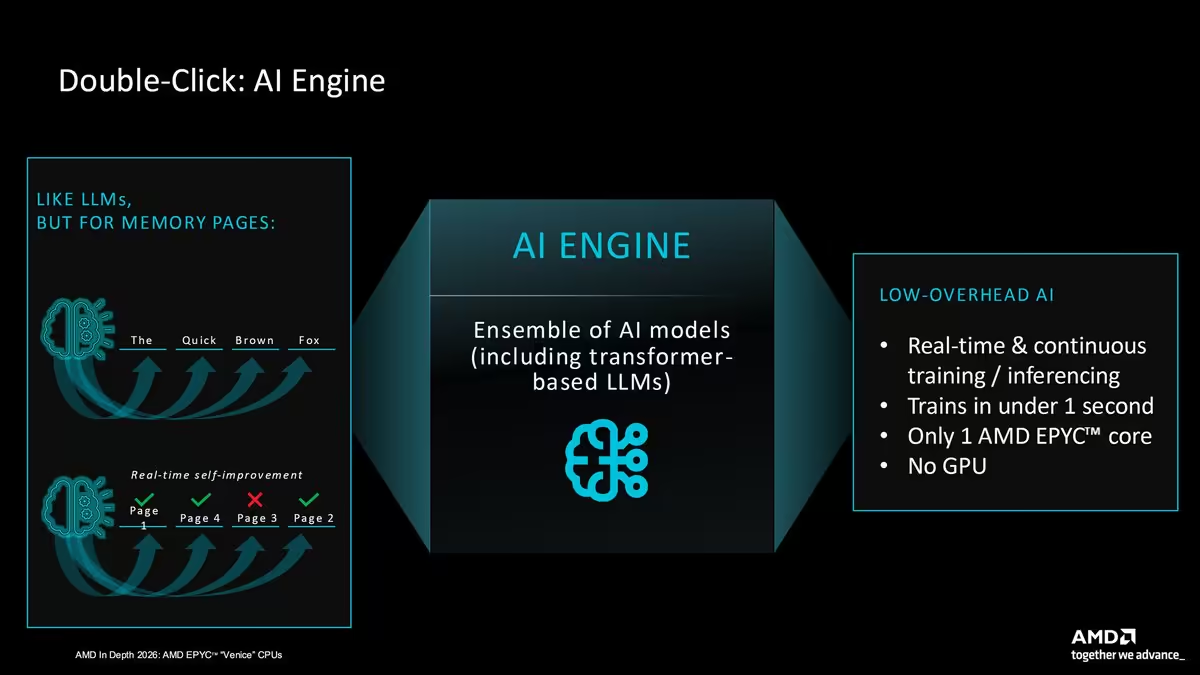
Trois composants assurent ce fonctionnement : un module noyau Linux léger, annoncé compatible avec toute distribution Linux ; un moteur réunissant plusieurs modèles d’IA, dont des LLM à base de Transformers ; et RAM View, l’outil de suivi en temps réel de l’utilisation mémoire. Le moteur apprend et réalise ses inférences en continu, avec un entraînement annoncé en moins d’une seconde, sur un seul cœur EPYC, sans GPU.
Moins de DRAM, avec un compromis mesuré selon la charge
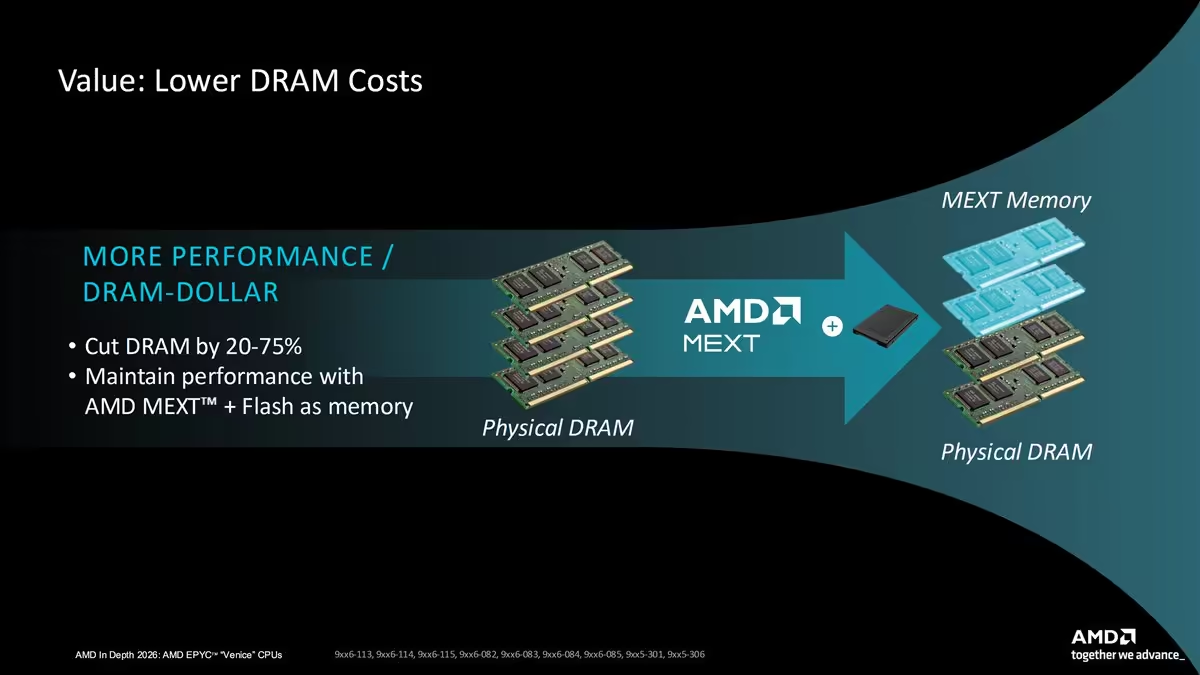
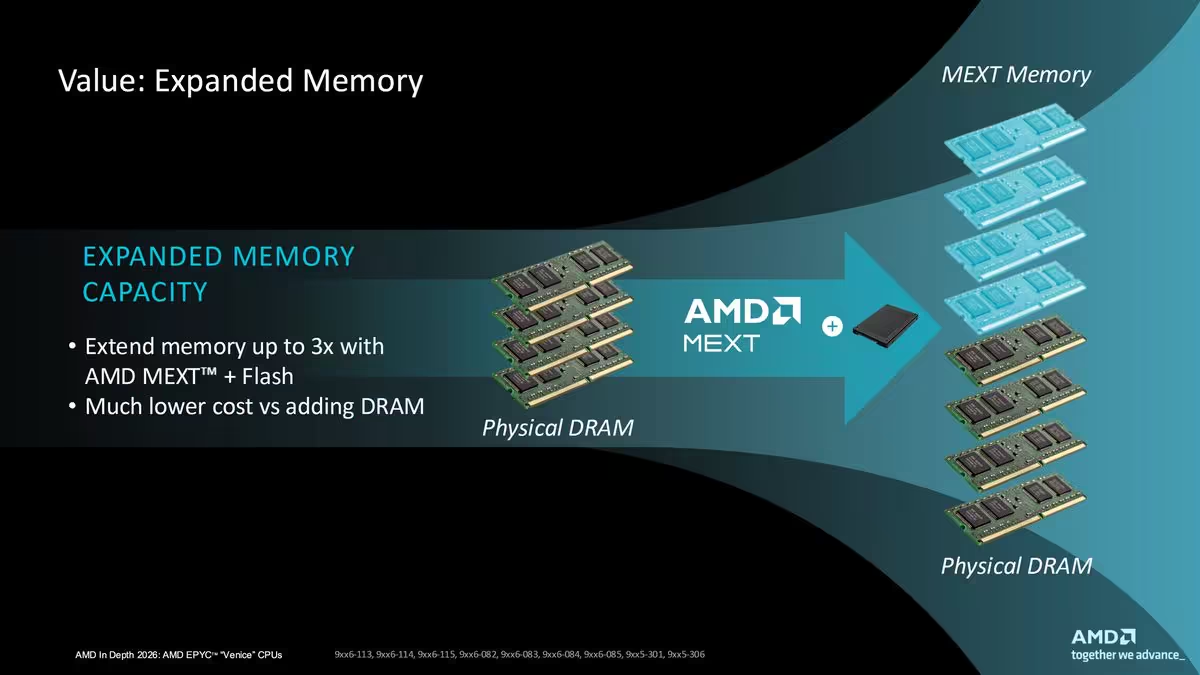
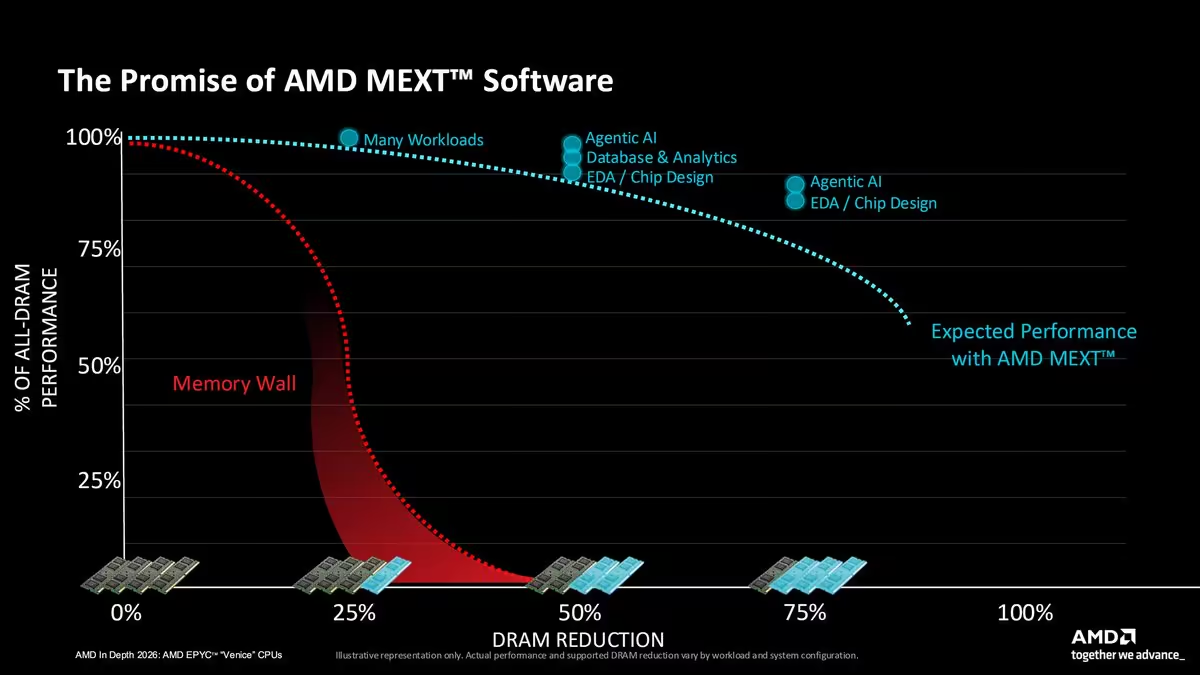
AMD revendique une réduction de 20 à 75 % des besoins en DRAM avec des performances proches de la configuration de référence. Autre possibilité : conserver la mémoire physique et étendre la capacité exploitable jusqu’à trois fois, pour un coût inférieur à celui d’un ajout équivalent en DRAM.
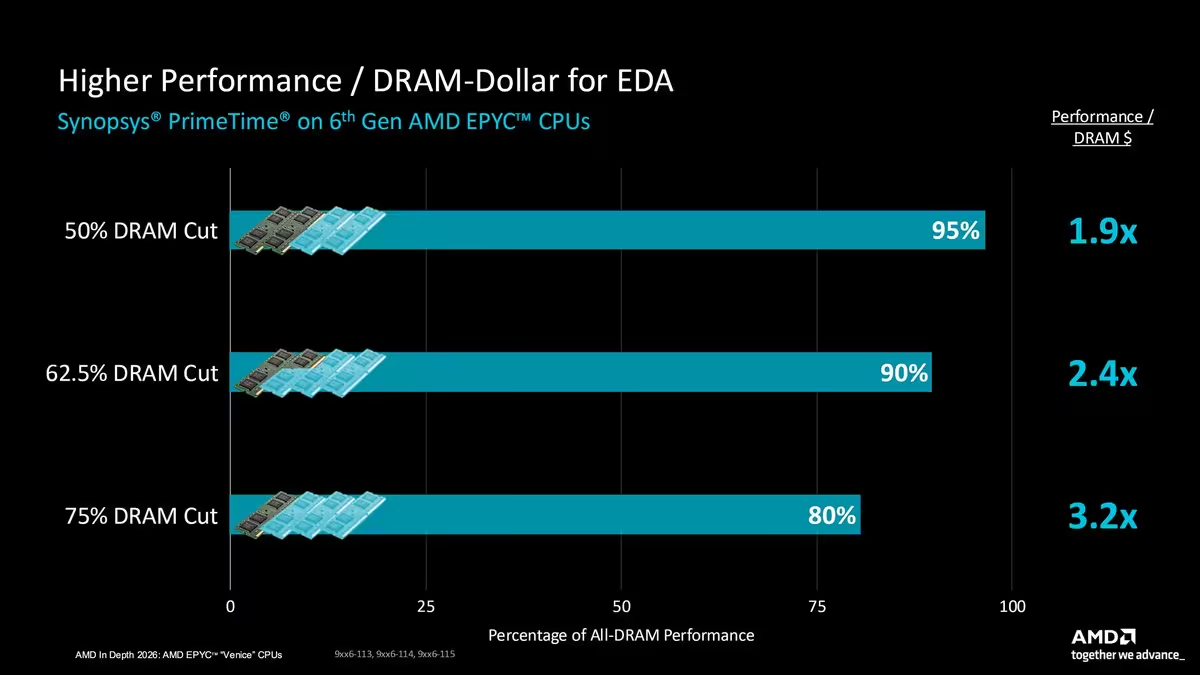
Le résultat le plus parlant concerne Synopsys PrimeTime sur les EPYC de 6e génération, Venice. Avec 50 % de DRAM en moins, MEXT conserve jusqu’à 95 % des performances de la configuration entièrement en mémoire vive. À 75 % de réduction, cette proportion descend à 80 %.
Le rapport performances par dollar dépensé en DRAM atteint respectivement 1,9× et 3,2×. Un palier intermédiaire, avec 62,5 % de DRAM en moins, affiche 2,4×. Il s’agit bien d’un indicateur rapporté au budget DRAM, et non d’une accélération équivalente du calcul ou d’un gain calculé sur le coût complet du serveur.
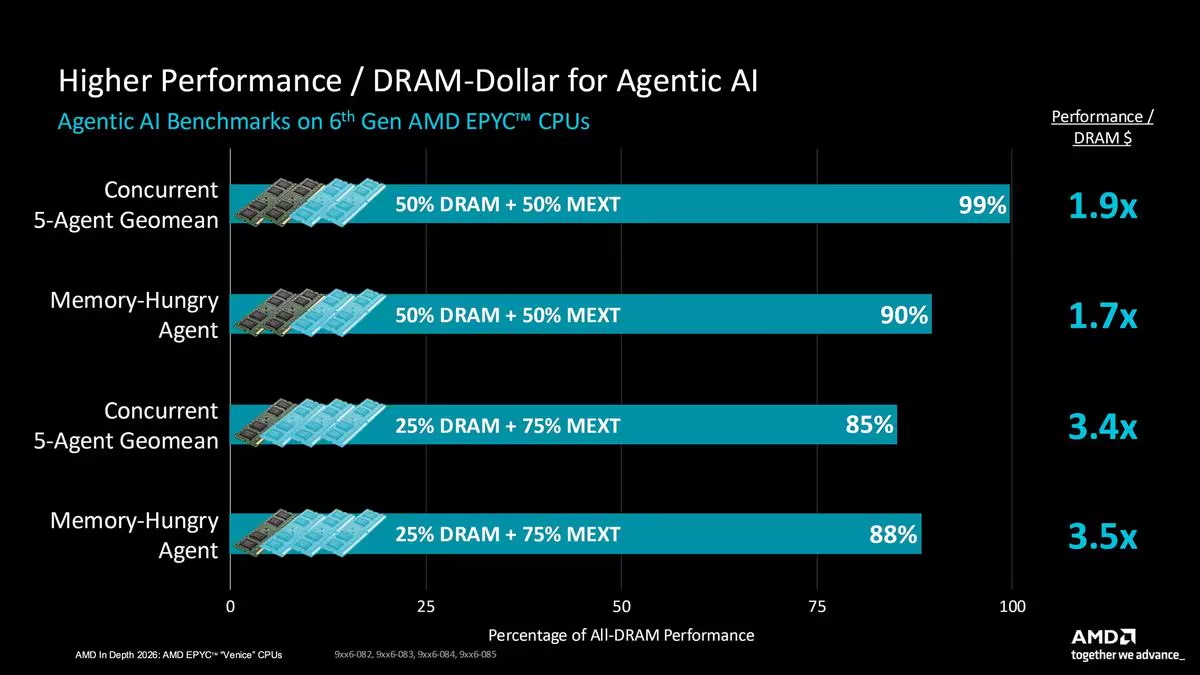
Pour l’IA agentique, une répartition de 50 % de DRAM et 50 % de Flash gérée par MEXT améliore ce même ratio de 90 % dans un scénario à cinq agents simultanés, et de 70 % pour un agent gourmand en mémoire. Avec 25 % de DRAM et 75 % de MEXT, les ratios atteignent respectivement 3,4× et 3,5×.
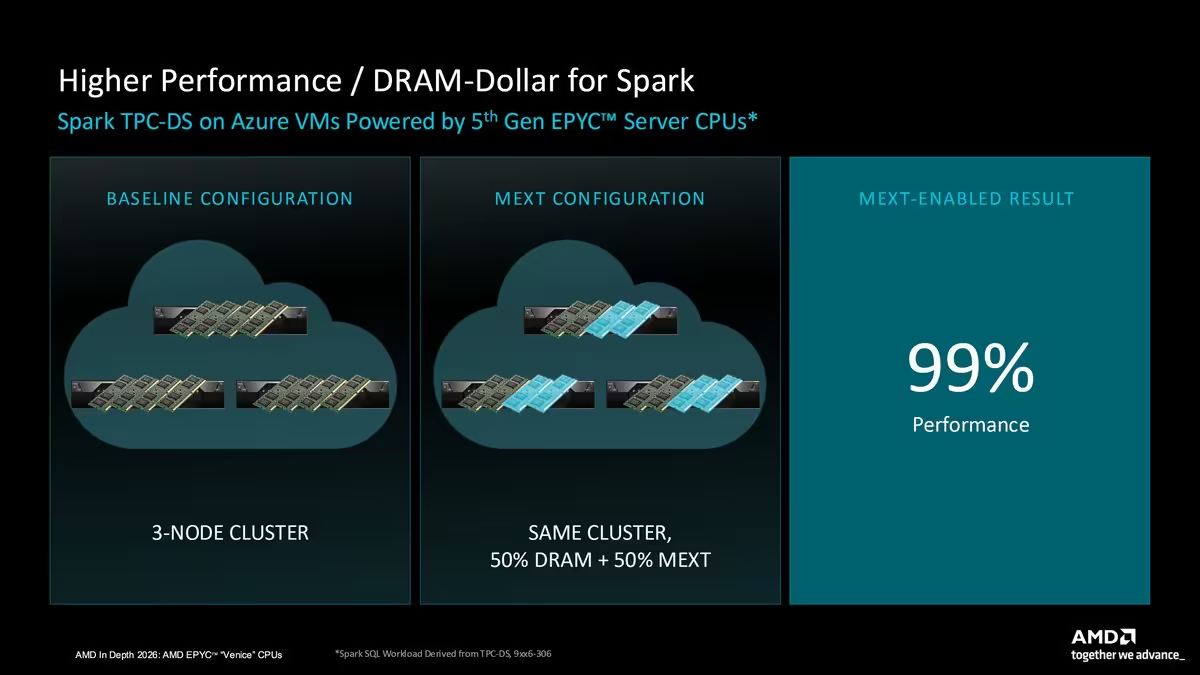
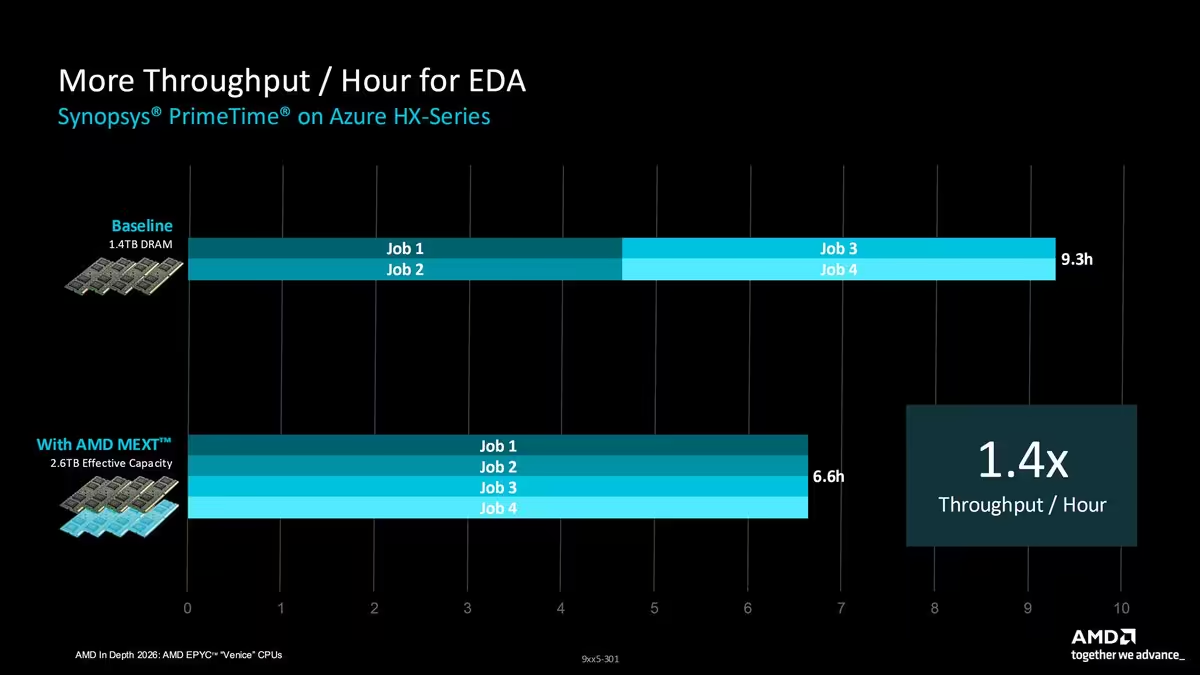
Sur Azure, un cluster de trois nœuds exécutant Spark TPC-DS sur des EPYC de 5e génération conserve jusqu’à 99 % des performances avec une répartition moitié DRAM, moitié MEXT. Une autre démonstration, sous Synopsys PrimeTime sur les instances Azure HX-Series, montre un débit de traitement horaire multiplié par 1,4.
Un déploiement EPYC engagé, la licence viendra ensuite
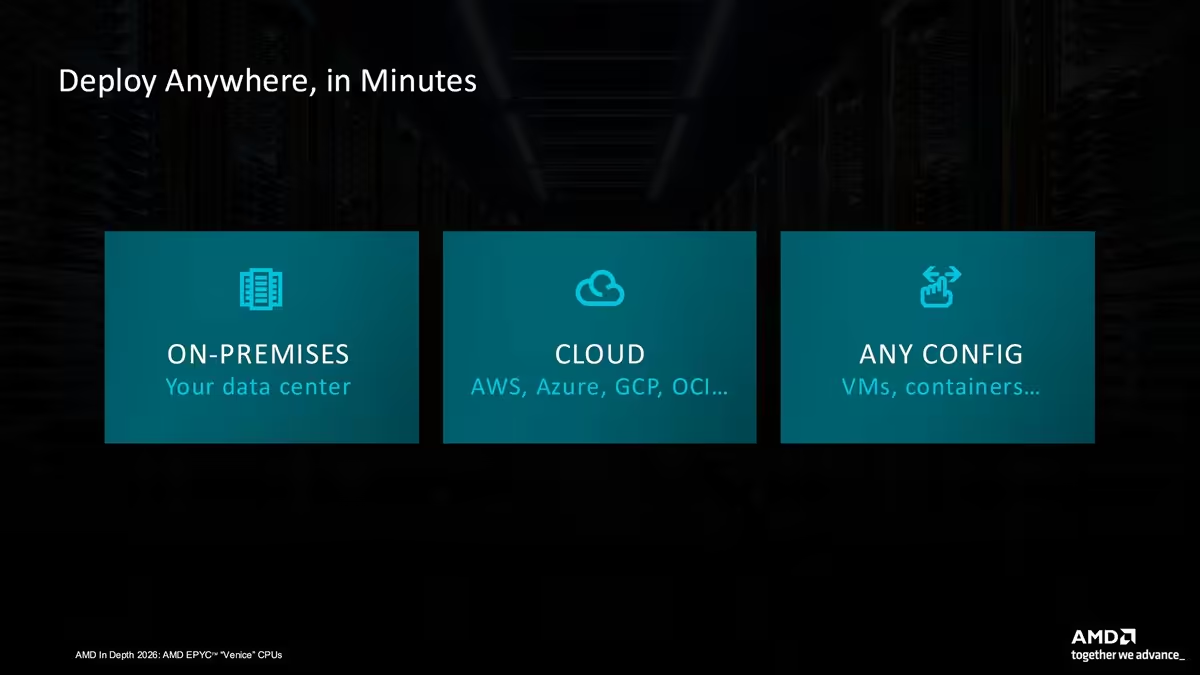
Les usages visés couvrent l’IA agentique, l’EDA et la conception de puces, les bases de données et l’analytique, ainsi que les médias et le divertissement. AMD présente des déploiements sur site et dans le cloud, notamment AWS, Azure, GCP et OCI, avec des machines virtuelles ou des conteneurs.
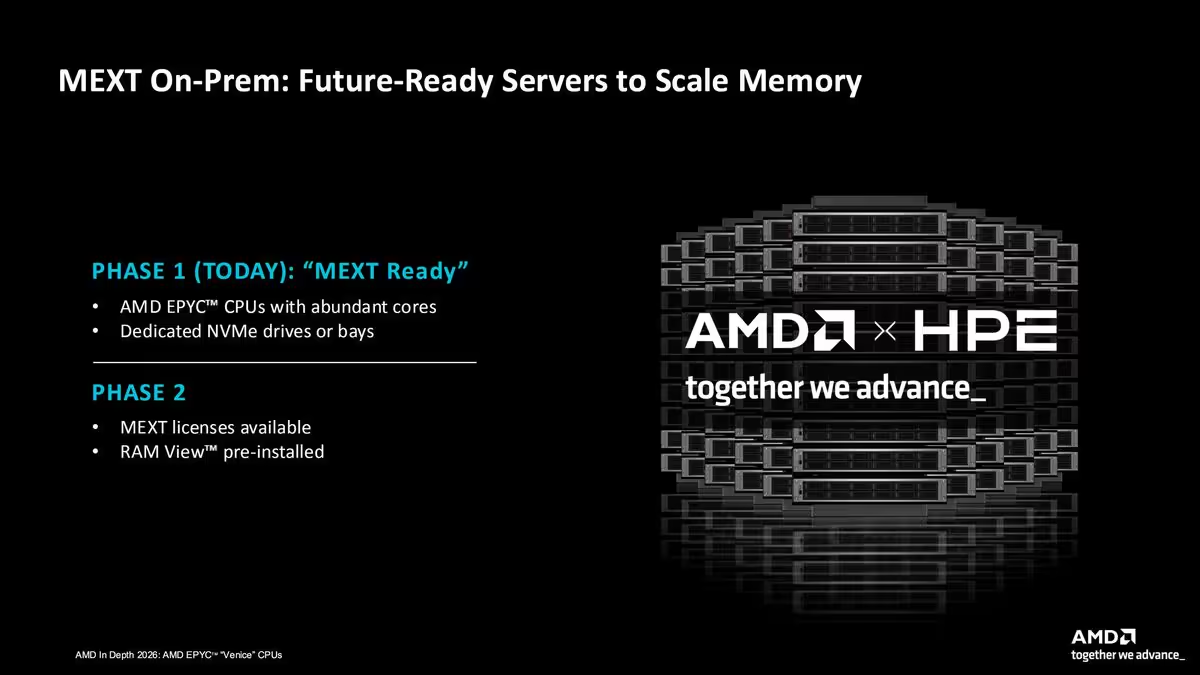
MEXT entre actuellement en phase 1, avec un déploiement possible sur des serveurs EPYC disposant de nombreux cœurs et de SSD NVMe dédiés ou de baies disponibles. La phase 2 prévoit une commercialisation sous licence, accompagnée de RAM View préinstallé. HPE figure également dans la présentation de serveurs « MEXT Ready ».
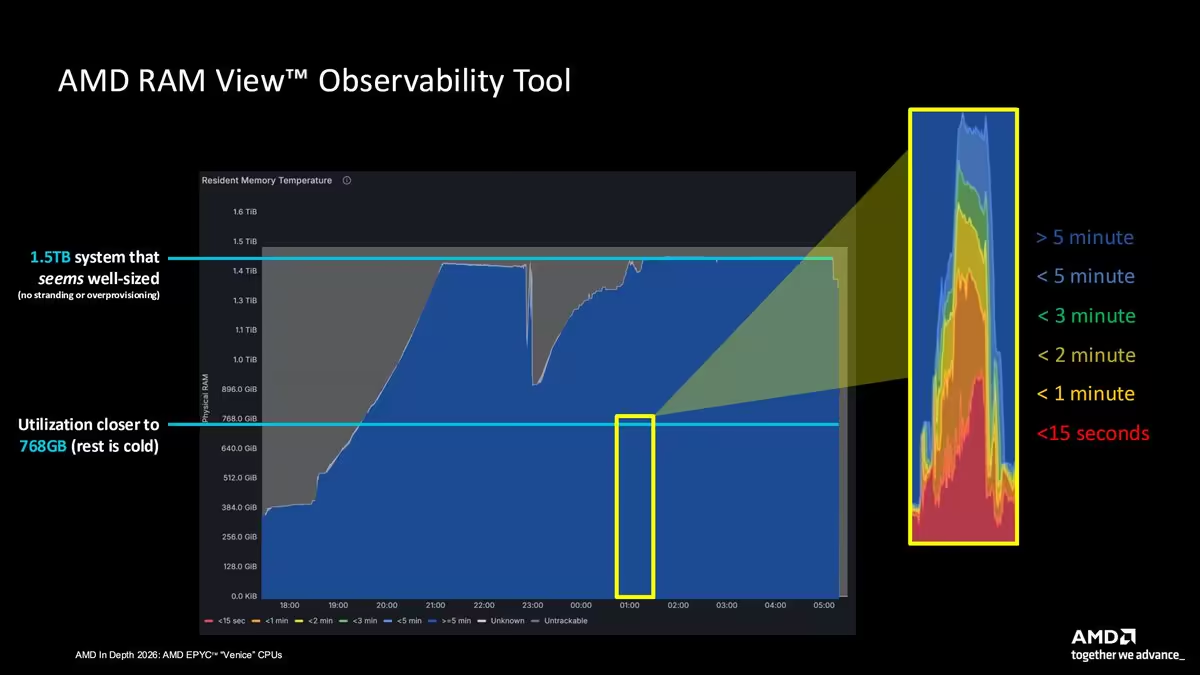
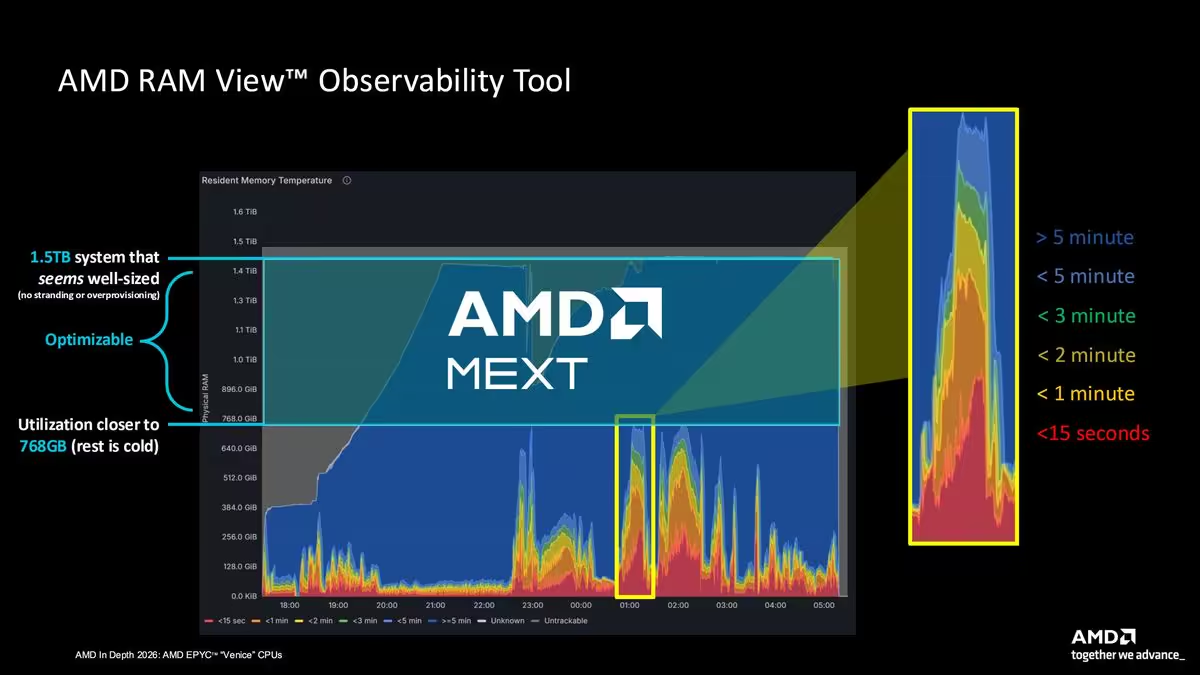
RAM View doit notamment permettre de distinguer la capacité allouée de celle réellement sollicitée. AMD illustre ce décalage avec un système de 1,5 To apparemment bien dimensionné, dont l’utilisation se rapproche en réalité de 768 Go, et une visualisation de l’activité des pages mémoire.
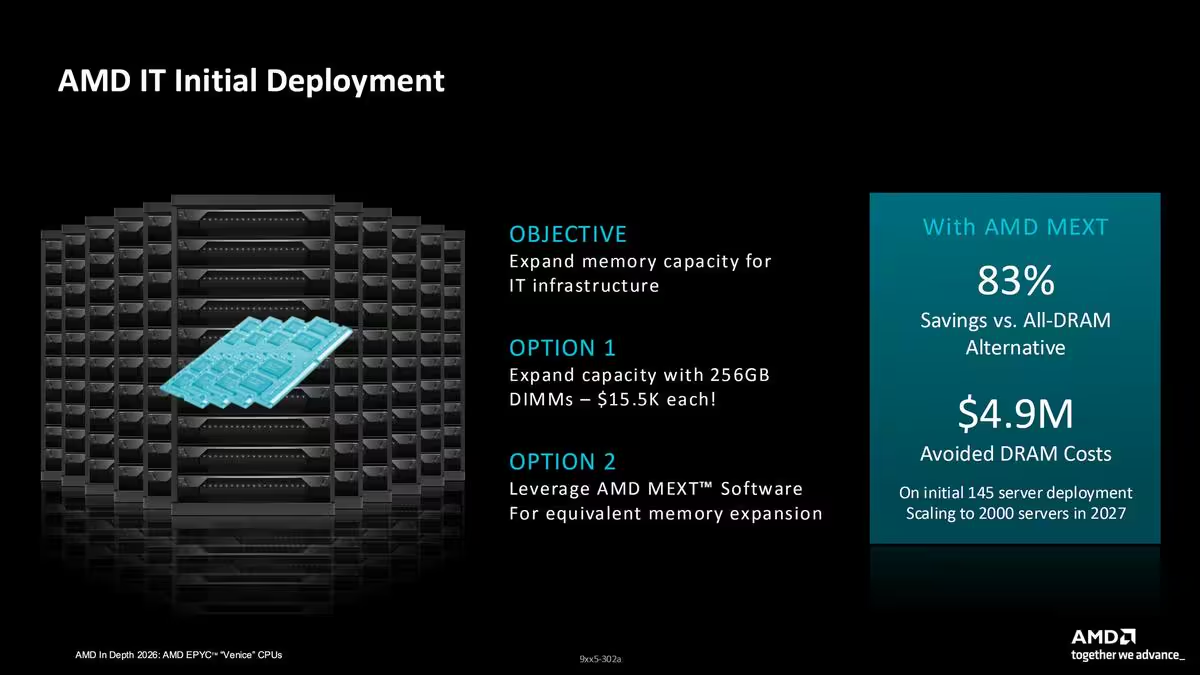
Pour son propre déploiement informatique initial de 145 serveurs, avec une montée prévue à 2 000 serveurs en 2027, AMD avance 83 % d’économies face à une extension entièrement en DRAM et 4,9 millions de dollars d’achats évités, soit environ 4,5 millions d’euros à titre indicatif. Le constructeur évoque aussi une application future au segment client, sans détailler de produit ni de calendrier grand public.
L’intérêt de cette approche dépend surtout de la part des données qui peut quitter durablement la DRAM et de la fiabilité des prédictions de retour. Les résultats de PrimeTime montrent déjà que la réduction de mémoire physique finit par coûter en performances : pour un exploitant, le bon dimensionnement devra donc intégrer les contraintes de latence et de débit de chaque charge, pas seulement le prix du gigaoctet.
Source : Wccftech

